Kimi·DeepSeek은 얼마나 저렴할까? ChatGPT·Claude 구독·API·보안 비교
Kimi와 DeepSeek을 쓰면 ChatGPT·Claude보다 얼마나 절약할 수 있을까? 해외 구독료와 최신 API 단가를 따로 비교하고, 같은 토큰 사용량의 비용을 계산한다. 성능 평가의 조건, 데이터 학습과 저장 정책, 실제 업무에 도입하는 방법까지 살펴본다.
기준일은 2026년 10월 24일이다. 가격은 공식 공개 페이지의 USD 표시액이며, 세금·환율·결제 경로에 따른 차이는 제외한다. 비용은 계산 예시이고, 실제 API 호출이나 자체 성능 벤치마크를 수행한 결과는 아니다.
1. 구독 서비스와 모델 API를 먼저 나누자
Kimi는 Moonshot AI의 대화·문서·코딩 제품군이고, DeepSeek은 무료 대화 앱과 유료 모델 API 등을 제공한다. ChatGPT와 Claude도 앱 구독과 개발자 API를 구분해야 한다. 같은 이름이 붙어 있어도 결제 대상과 사용량 계산이 다르다.
구독은 앱의 편의 기능, 코딩 도구, 파일 처리, 연결 서비스와 일정 사용량을 묶어 산다. API는 자신의 앱이나 자동화에서 모델을 호출한 만큼 지불한다. 앱의 월 20달러와 API의 100만 토큰당 2달러는 직접 비교할 수 없다. 같은 구독명인 Plus·Pro도 회사마다 기능과 허용량이 다르다.
2. 구독료: Kimi 해외 Plus는 5% 저렴하다
다음은 공개 해외 USD 화면의 개인 요금이다. 연 결제의 월 환산액과 월 결제 가격을 섞지 않았다.
| 서비스 | 월 결제 | 연 결제 또는 상위 플랜 | 해석 |
|---|---|---|---|
| Kimi Plus | $19 | 연 $180, 월 환산 $15 | ChatGPT Plus·Claude Pro 월 결제보다 $1, 5% 저렴 |
| Kimi Pro / Max / Ultra | $39 / $99 / $199 | 연 $372 / $948 / $1,908 | 이름이 비슷해도 타사 플랜과 동등한 사용량은 아님 |
| DeepSeek 공식 앱 | 무료 | 앱과 유료 API는 별도 | 기본 대화용으로 먼저 평가할 수 있음 |
| ChatGPT Go / Plus | $8 / $20 | Pro $100 / $200 / $500 | Go와 Plus의 모델·기능 범위도 다름 |
| Claude Pro | $20 | 연 $200 | 연 결제 총액으로는 Kimi Plus가 10% 저렴 |
| Claude Max | $100부터 | 5x / 20x 사용량 플랜 | 해당 플랜의 API 크레딧도 고려 |
출처: Kimi 해외 구독 화면, DeepSeek 공식 무료 앱 안내, ChatGPT 요금, Claude 요금.
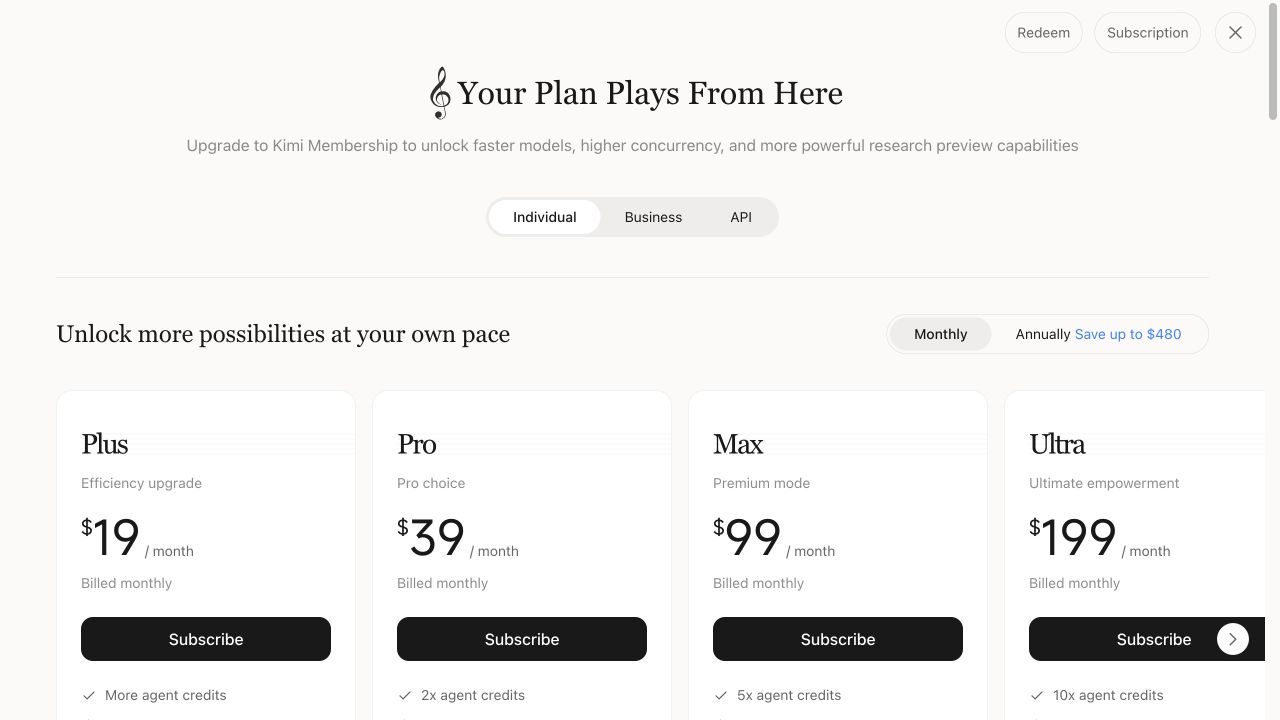
공식 공개 구독 화면에서 Monthly를 선택한 USD 가격. 2026-10-24 캡처. 출처 · 이미지 크게 보기.
검색에서 보이는 Kimi Go ¥49, Plus ¥99는 중국 내 요금 안내다. 이를 환산해 한국 사용자의 해외 구독료라고 소개하면 잘못된 비교가 된다. 위 표는 확인 당시 해외 화면이며, 실제 구매 가능 플랜과 최종 금액은 본인 계정 결제 화면을 기준으로 확인한다.
또한 무료 비교에서는 ChatGPT·Claude에도 무료 플랜이 있다. DeepSeek 무료와 타사 최고가 플랜만 나란히 놓고 절감률을 계산하는 것은 기능·사용량 비교가 아니다. Kimi 역시 월 공유 크레딧과 Kimi Code의 사용량 제한이 있으므로, 월 요금만 보고 무제한으로 이해하면 안 된다. (Kimi 사용량 규칙)
3. API 단가: 최신 Kimi는 중급 GPT·Claude와 같다
단위는 100만 토큰당 USD다. OpenAI는 Standard·짧은 컨텍스트, Haiku는 프롬프트 10만 토큰 이하 구간이다. 입력은 캐시 미적중, 출력은 과금 대상 출력 전체이며, 캐시 적중 입력은 별도 열로 적었다.
| 모델 / 요금 구간 | 입력 | 출력 | 캐시 적중 입력 |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017 / 피크 | $0.30 | $1.20 | $0.006 |
| DeepSeek V4.1 Flash-1017 / 비피크 | $0.15 | $0.60 | $0.003 |
| DeepSeek V4 Pro-0813 / 피크 | $1.32 | $3.96 | $0.044 |
| DeepSeek V4 Pro-0813 / 비피크 | $0.66 | $1.98 | $0.022 |
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Luna / Claude Haiku 5.5 | $0.10 | $0.50 | $0.01 |
출처: DeepSeek 가격표, Kimi 가격표, OpenAI API 가격표, Claude API 가격표.
K3.1 Pro의 기본 입력·출력 단가는 Sol·Sonnet과 같고, Opus의 절반이다. 반면 캐시 적중 입력은 Sol·Sonnet보다 비싸다. Highspeed는 별도 요금이므로 일반 모델의 단가를 그대로 적용하면 안 된다. 오래된 K2 단가만으로 최신 Kimi 전체가 저렴하다고 설명하는 것도 부정확하다. 공식 문서는 K2의 신규 사용자 제공을 10월 31일부터 중단하고, 전체 종료를 12월 말로 예고한다.
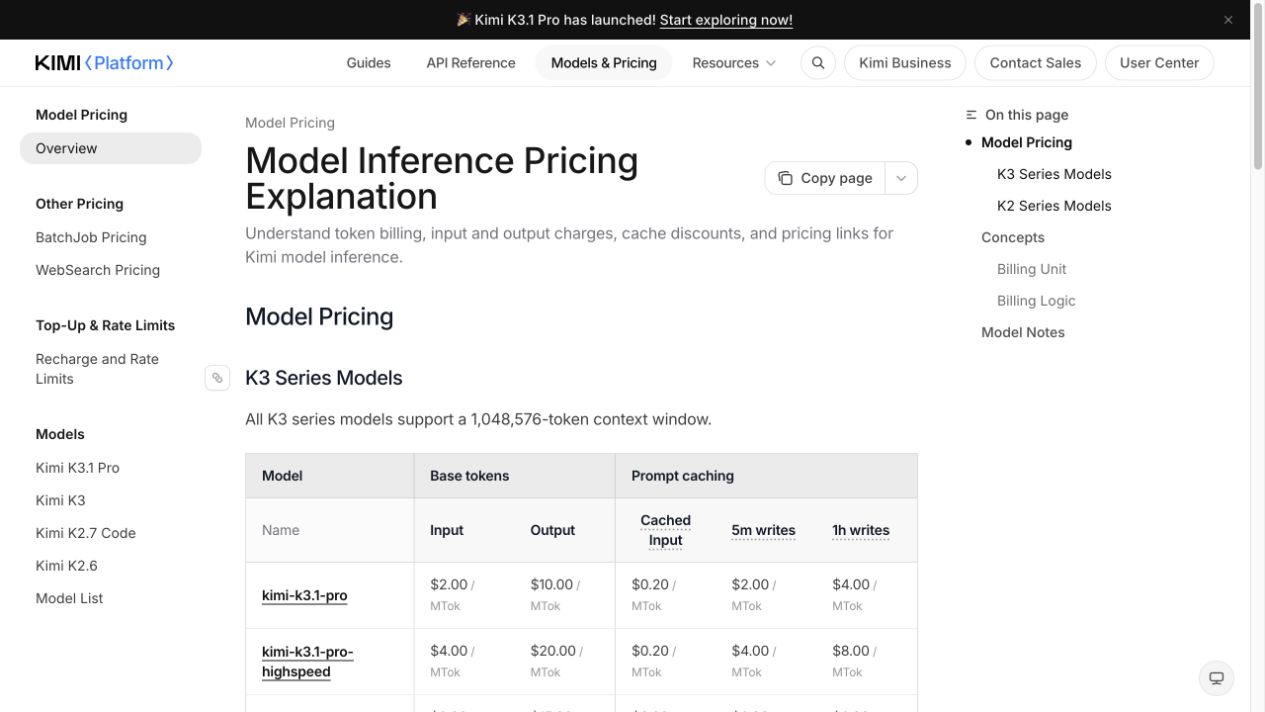
공식 API 가격표의 K3.1 Pro·Highspeed 부분. 구독료와 별개의 종량제이며 캐시 쓰기 항목도 구분되어 있다. 2026-10-24 캡처. 출처 · 이미지 크게 보기.
DeepSeek 피크 시간은 중국 공휴일을 제외한 월~금 UTC 01–04시, 06–10시다. 한국 시간으로는 평일 10–13시, 15–19시, 나머지는 비피크다. 모델 ID는 Flash에 deepseek-flash, Pro에 deepseek-v4-pro를 사용한다. 이름에 Pro가 붙었다고 모든 기능이 상위인 것도 아니다. 현재 표에서는 Flash만 이미지 입력을 지원한다.
4. 같은 사용량이면 실제 계산은 얼마나 차이 날까
예를 들어 한 달에 1만 번 호출하고, 매 호출이 입력 1,000토큰·과금 출력 200토큰을 쓴다고 가정하자. 합계는 입력 1,000만·출력 200만 토큰이다. 재시도, 도구, 저장 비용과 세금은 없고, 입력 캐시 적중은 0이다. 캐시 쓰기는 OpenAI·Claude에서 사용하지 않으며, Kimi의 기본 5분 쓰기 단가는 일반 입력과 같다.
cost_usd = input_tokens / 1_000_000 * input_rate
         + output_tokens / 1_000_000 * output_rate
saving_pct = (1 - candidate_cost / baseline_cost) * 100| 모델 / 시간대 | 월 계산액 | Sol·Sonnet $40 대비 절감 | Opus $80 대비 절감 |
|---|---|---|---|
| DeepSeek Flash 피크 | $5.40 | 86.5% | 93.25% |
| DeepSeek Flash 비피크 | $2.70 | 93.25% | 96.63% |
| DeepSeek Pro 피크 | $21.12 | 47.2% | 73.6% |
| DeepSeek Pro 비피크 | $10.56 | 73.6% | 86.8% |
| Kimi K3.1 Pro | $40 | 0% | 50% |
| Kimi Highspeed / Claude Opus 5.5 | $80 | 절감 없음, 2배 비용 | 0% |
| GPT-6.1 Sol / Claude Sonnet 5.5 | $40 | 0% | 50% |
| GPT-6 Luna / Claude Haiku 5.5 | $2 | 95% | 97.5% |
| GPT-6 Astra | $200 | 절감 없음, 5배 비용 | 절감 없음, 2.5배 비용 |
이는 같은 토큰 수의 가격 비교다. 같은 요청을 넣으면 토크나이저·추론 길이·재시도 수가 달라져 실제 청구액도 달라진다. Luna·Haiku가 요구 품질을 만족하는 분류·추출 작업이라면 DeepSeek Flash보다도 비용이 낮다. 국적보다 업무에 필요한 모델 등급을 먼저 정해야 한다.
5. 절감률을 바꾸는 캐시·추론·구독 크레딧
긴 문서를 반복해서 보내는 작업은 캐시가 중요하다. 그러나 입력 전체에 캐시 최저가를 곱하면 안 된다. 적중·미적중·쓰기 토큰을 나누고, 쓰기 TTL과 최초 요청 비용도 계산한다. Kimi K3.1 Pro는 5분 쓰기 $2, 1시간 쓰기 $4이며, 캐시 문서는 읽기·쓰기·나머지 입력을 서로 겹치지 않는 항목으로 설명한다.
추론 모델은 화면에 보이는 답변보다 많은 과금 출력 토큰을 쓸 수 있다. 위 예시의 200토큰은 그 전체를 포함하는 가정이다. 에이전트가 파일을 다시 읽거나 도구를 호출하고 실패한 작업을 재시도하면 별도 요청이 쌓인다. OpenAI의 Flex/Batch, Claude Batch처럼 할인 처리 방식이 맞는 업무라면 기본 단가보다 비용이 줄어든다. 검색·실행 환경·저장료까지 합쳐 비교해야 한다.
구독과 API는 별도 상품이지만, 현재 Claude Max에는 API 크레딧 혜택이 있다. Max 5x는 월 $100, Max 20x는 $200이며, 적격 계정에서 Console 조직을 연결해 받아야 한다. 신규 구독자는 7일 이후 수령 가능하고 미사용분은 이월되지 않는다. Claude Code나 앱 추가 사용량에는 적용되지 않는다. (공식 크레딧 안내)
이미 Max를 업무용으로 구독하고 해당 크레딧이 남는다면, 표의 API $80 작업을 돌리는 추가 현금 지출이 0일 수 있다. 구독료 자체가 없어지는 것은 아니다. 기존 구독을 유지하는 경우의 추가 지출과, 새로 구독하는 경우의 총지출을 각각 계산해야 한다.
6. 성능: 충분히 경쟁력 있지만 한 줄 순위는 피하자
Kimi·DeepSeek을 저성능 대체품으로만 보는 것은 최신 공개 평가와 맞지 않는다. 다만 아래 수치는 제공사 발표와 그 발표가 인용한 결과이며, 이 글이 동일 환경에서 재측정한 값은 아니다.
| Terminal-Bench 4.0 모델 | 공개 점수 | 읽는 방법 |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | Kimi 발표, Claude-Code harness·max effort |
| Claude Opus 5.5 | 66.4% | Kimi 발표가 인용한 공개 결과 |
| GPT-6 Astra | 58.2% | Kimi 발표가 인용한 공개 결과 |
| DeepSeek V4.1 Flash-1017 | 42.3% | DeepSeek 모델 카드, Claude Code harness |
Kimi 기술 보고는 경쟁 모델 점수를 발표문 또는 공식 순위표의 최댓값에서 가져왔다고 명시한다. 따라서 같은 비용·추론 예산의 통제 실험이 아니다. DeepSeek 모델 카드는 다른 평가인 DeepSWE v1.1에서 77.0을 보고하지만, 이를 Terminal-Bench 점수와 섞어 순위를 만들 수 없다.
실무에서는 한국어 문서 요약, 구조화 JSON, 저장소 수정, 긴 문서 근거 찾기처럼 내 업무별로 성공 조건을 정해 평가한다. 코딩 벤치마크 점수가 한국어 문체·도표 읽기·회사 저장소 이해까지 보장하지 않는다. 모델 외에도 도구 구성, 실행 시간, effort, 컨텍스트가 결과를 바꾼다.
공개 데이터 30~50건으로 후보 모델을 비교하면서 정답률, 인용 오류, 테스트 통과, 95백분위 지연 시간, 재시도와 사람의 수정 시간을 함께 기록하면 도입 판단에 더 도움이 된다. 합격 건당 비용은 총 API 비용을 검수 통과 건수로 나눠 계산한다.
7. 보안: 앱·API·자체 호스팅의 조건이 다르다
출신 국가만으로 안전을 판정할 수는 없다. 어떤 서비스에 무엇을 보내며, 어디에 저장되고, 학습과 로그에 어떻게 쓰이는지가 실제 검토 대상이다. 유료라는 사실만으로 비학습이나 무보관이 보장되지 않는다.
| 사용 경로 | 공식 문서에서 확인한 내용 | 업무 도입 때 확인할 점 |
|---|---|---|
| Kimi 일반 서비스 | 일반 개인정보 정책에 중국 내 저장, 비식별화한 입출력의 모델 개선 활용과 거부 요청 절차가 있음 | 개인 구독과 업무용 API의 약관을 구분 |
| Kimi API | 별도 도움말은 API 입출력을 모델 학습·개선에 쓰지 않는다고 명시. K3.1 발표는 ZDR 제공을 안내 | 실제 계약·엔드포인트의 저장 지역, 로그 보관, ZDR 적용 조건 확인 |
| DeepSeek 직접 서비스 | 정책에 중국 내 처리·저장, 기술 개선·학습 목적과 거부 권리가 명시됨 | 검토한 공개 문서에서 API 전체의 비학습·무보관 보증은 확인하지 못함 |
| OpenAI API | 기본적으로 학습에 사용하지 않음. 기본 악용 모니터링 로그는 최대 30일, 기능별 상태 저장은 별도 | store=false만으로 모든 로그가 사라지지 않음. ZDR 자격·기능 확인 |
| Claude API | 상용 API는 기본 비학습. 일반 입력·출력은 원칙적으로 30일 내 삭제하되 예외가 있음 | Files·안전 조사·법적 보관·모델별 예외와 별도 계약 확인 |
출처: Kimi 일반 정책, Kimi API 보안 안내, K3.1 제공 안내, DeepSeek 정책, OpenAI 데이터 제어, Claude 학습 정책, Claude 보관 정책.
Kimi API의 비학습 안내를 일반 채팅 앱에 확대 적용하거나, DeepSeek 정책에 보증이 없다는 이유로 모든 API 입력이 반드시 학습된다고 단정하면 안 된다. 비학습과 ZDR, 저장 지역은 서로 다른 조건이다. ChatGPT·Claude의 개인용 플랜도 API의 상용 정책과 같다고 가정하지 않는다.
자체 호스팅은 별도 선택지다. DeepSeek Flash-1017은 공식 모델 카드에서 MIT 라이선스의 가중치를 제공한다. 반면 Kimi K3.1 Pro의 전체 가중치는 기준일 현재 11월 4일까지 공개 예정이므로 지금 곧바로 같은 모델을 자체 운영할 수 있다고 안내하면 안 된다. 공개 이후에도 라이선스, GPU·메모리, 추론 엔진과 운영비를 검토해야 한다.
오픈 모델을 조직 내부에서 추론하면 외부 모델 API 전송을 줄일 수 있지만, 원격 검색·도구·텔레메트리가 연결되어 있으면 다른 전송 경로가 생긴다. 외부 중계 API를 쓰면 중계 사업자와 실제 추론 사업자의 정책을 모두 확인한다. 어떤 모델이든 프롬프트 인젝션, 잘못된 도구 실행, 키 유출 가능성은 남는다.
8. 실제 도입: 작은 업무부터 비용과 품질을 함께 기록한다
- 데이터를 나눈다. 공개 문서·합성 데이터로 시작한다. 고객 정보, 인증 키, 미공개 소스는 조직이 승인한 처리 경로와 계약이 확인된 뒤 사용한다.
- 평가 업무를 고정한다. 예를 들어 공개 릴리스 노트 50건을 같은 JSON 스키마로 요약한다. 원문에 없는 날짜·기능을 만들어 내면 실패로 정한다.
- 모델 ID와 조건을 기록한다.
deepseek-flash,kimi-k3.1-pro등 실제 응답 모델·effort·토큰·캐시·시간대·오류를 남긴다. API 키는 서버의 비밀 저장소나 환경 변수에 보관한다. - 검증 후에 상위 모델로 보낸다. JSON 오류, 출처 누락, 테스트 실패처럼 확인 가능한 조건을 쓴다. 모델 자신의 자신감 표현만으로 재시도를 결정하지 않는다.
- 일주일 뒤 총비용으로 판정한다. API 청구액, 상위 모델 재처리, 사람의 수정 시간, 지연과 운영 부담을 합산한다. 품질·데이터 요건을 만족한 작업부터 확대한다.
위 월 사용량 예시에서 모든 작업을 Flash 피크로 처리하고, 20%를 Sol·Sonnet에 같은 길이로 다시 요청한다면 $5.40 + $8 = $13.40, 처음부터 $40을 쓰는 경우보다 66.5% 적다. 이는 성공률을 측정한 결과가 아니라 운영 설계의 계산 예시다. 검증 호출·추가 컨텍스트·검색 비용이 붙으면 절감 폭은 줄어든다.
개인 사용자에게는 익숙한 앱에서 시간을 얼마나 줄이는지가 월 1달러 차이보다 클 수 있다. 개발팀은 대량 처리에 DeepSeek을 검토하고, 높은 난도의 작업에서 Kimi·GPT·Claude를 같은 평가 세트로 비교할 수 있다. 반복 분류라면 Luna·Haiku도 후보에 넣는다. 가장 싼 토큰보다, 요구 품질과 데이터 조건을 만족한 결과를 가장 적은 총비용으로 만드는 조합을 찾는 것이 실용적이다.
How much can Kimi and DeepSeek save compared with ChatGPT and Claude? This guide separates international subscriptions from current API rates, calculates costs for equal token volumes, and examines benchmark conditions, training and storage policies, and practical adoption.
All information was checked on October 24, 2026. Prices are public USD amounts; taxes, exchange rates and payment-channel differences are excluded. Costs are worked examples, not results from live API calls or our own performance benchmark.
1. Separate app subscriptions from model APIs
Kimi is Moonshot AI's family of chat, document and coding products. DeepSeek offers a free chat app and paid model APIs, among other products. With ChatGPT and Claude, app subscriptions and developer APIs also need to be considered separately. Shared branding does not mean shared billing.
A subscription bundles app features, coding tools, file handling, integrations and a usage allowance. An API charges for model calls made by your own applications or automations. An app at $20 a month cannot be directly compared with an API at $2 per million tokens. Even plan names such as Plus and Pro represent different capabilities and allowances across companies.
2. Subscriptions: international Kimi Plus is 5% cheaper
These are individual prices displayed on public international USD pages. Monthly billing and the monthly equivalent of an annual commitment are kept separate.
| Service | Monthly billing | Annual billing or higher plans | Interpretation |
|---|---|---|---|
| Kimi Plus | $19 | $180/year, equivalent to $15/month | $1 or 5% below monthly ChatGPT Plus and Claude Pro |
| Kimi Pro / Max / Ultra | $39 / $99 / $199 | $372 / $948 / $1,908 per year | Similar names do not imply equal allowances across providers |
| Official DeepSeek app | Free | App and paid API are separate | A starting point for evaluating everyday chat |
| ChatGPT Go / Plus | $8 / $20 | Pro at $100 / $200 / $500 | Go and Plus also differ in models and features |
| Claude Pro | $20 | $200/year | Kimi Plus is 10% cheaper by annual total |
| Claude Max | From $100 | 5x / 20x usage plans | Consider the included API credits too |
Sources: Kimi international subscription page, DeepSeek's free app, ChatGPT pricing, Claude pricing.
Public official subscription page with Monthly selected and prices in USD. Captured October 24, 2026. Source · View full-size image.
The Kimi Go ¥49 and Plus ¥99 prices found in searches belong to the China plan documentation. Converting those figures and presenting them as international prices for Korean users would be misleading. The table reflects the international page at the time of checking; available plans and final charges should be verified in your own checkout.
ChatGPT and Claude also have free plans. Comparing free DeepSeek solely with competitors' most expensive plans is not a feature or usage comparison. Kimi has shared monthly credits and separate Kimi Code usage limits, so its monthly fee should not be read as unlimited usage. (Kimi usage rules)
3. API rates: current Kimi matches midrange GPT and Claude
All amounts are USD per million tokens. OpenAI rates are Standard with short context; Haiku rates apply to prompts of up to 100,000 tokens. Input means a cache miss, output means all billable output, and cached input has its own column.
| Model / rate period | Input | Output | Cached input |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017 / peak | $0.30 | $1.20 | $0.006 |
| DeepSeek V4.1 Flash-1017 / off-peak | $0.15 | $0.60 | $0.003 |
| DeepSeek V4 Pro-0813 / peak | $1.32 | $3.96 | $0.044 |
| DeepSeek V4 Pro-0813 / off-peak | $0.66 | $1.98 | $0.022 |
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Luna / Claude Haiku 5.5 | $0.10 | $0.50 | $0.01 |
Sources: DeepSeek rates, Kimi rates, OpenAI API rates, Claude API rates.
K3.1 Pro's base input and output rates equal Sol and Sonnet, and are half those of Opus. Its cached input is more expensive than Sol or Sonnet. Highspeed has separate rates, so the standard model's price cannot be applied to it. Using old K2 prices to describe all current Kimi models is also inaccurate: official documentation announces that K2 access for new users ends October 31, with full retirement planned for late December.
K3.1 Pro and Highspeed on the official API rate page. This is usage billing separate from subscriptions, with distinct cache-write items. Captured October 24, 2026. Source · View full-size image.
DeepSeek peak periods are Monday–Friday, excluding Chinese public holidays, at 01:00–04:00 and 06:00–10:00 UTC. In Korea that is 10:00–13:00 and 15:00–19:00 on weekdays; other times are off-peak. Use deepseek-flash for Flash and deepseek-v4-pro for Pro. A Pro label does not imply every capability is superior: the current table lists image input only for Flash.
4. What does equal usage actually cost?
Assume 10,000 monthly calls, each with 1,000 input tokens and 200 billable output tokens. That totals 10 million input and 2 million output tokens. There are no retries, tools, storage charges or taxes, and no input cache hits. OpenAI and Claude cache writes are unused; Kimi's default five-minute write rate equals its regular input rate.
cost_usd = input_tokens / 1_000_000 * input_rate
         + output_tokens / 1_000_000 * output_rate
saving_pct = (1 - candidate_cost / baseline_cost) * 100
| Model / period | Calculated monthly cost | Savings vs Sol/Sonnet at $40 | Savings vs Opus at $80 |
|---|---|---|---|
| DeepSeek Flash peak | $5.40 | 86.5% | 93.25% |
| DeepSeek Flash off-peak | $2.70 | 93.25% | 96.63% |
| DeepSeek Pro peak | $21.12 | 47.2% | 73.6% |
| DeepSeek Pro off-peak | $10.56 | 73.6% | 86.8% |
| Kimi K3.1 Pro | $40 | 0% | 50% |
| Kimi Highspeed / Claude Opus 5.5 | $80 | No saving; 2× the cost | 0% |
| GPT-6.1 Sol / Claude Sonnet 5.5 | $40 | 0% | 50% |
| GPT-6 Luna / Claude Haiku 5.5 | $2 | 95% | 97.5% |
| GPT-6 Astra | $200 | No saving; 5× the cost | No saving; 2.5× the cost |
This is a price comparison for equal token counts. The same request can produce different token counts, reasoning lengths and retries across models, changing actual bills. If Luna or Haiku meets the quality requirement for classification or extraction, it costs less than even DeepSeek Flash. Choose the model tier your task requires before considering its country of origin.
5. Caching, reasoning and subscription credits change savings
Caching matters when repeatedly sending long documents. But multiplying all input by the lowest cached-input price gives the wrong answer. Separate cache reads, misses and writes, including TTL and the first request. Kimi K3.1 Pro charges $2 for five-minute writes and $4 for one-hour writes; its cache documentation describes reads, writes and remaining input as mutually exclusive categories.
Reasoning models may produce more billable output tokens than appear in the visible answer. The example's 200 tokens includes all billable output. Agents add requests when rereading files, calling tools or retrying failures. OpenAI Flex/Batch and Claude Batch can reduce costs for suitable workloads. Search, execution environments and storage also belong in the total.
Subscriptions and APIs are separate products, but Claude Max currently includes API credits: $100 monthly for Max 5x and $200 for Max 20x, claimed by linking a Console organization on an eligible account. New subscribers can claim after seven days; unused credits do not roll over. They do not cover Claude Code or extra app usage. (Official credit guide)
If you already subscribe to Max for work and have unused eligible credits, the example's $80 API workload could require no additional cash payment. The subscription itself still costs money. Calculate incremental spending while keeping an existing plan and total spending when buying a new plan separately.
6. Performance: competitive, but not a universal ranking
Recent public evaluations do not support treating Kimi and DeepSeek simply as low-performance substitutes. The figures below come from provider reports and results cited in those reports, not our own controlled rerun.
| Terminal-Bench 4.0 model | Public score | How to read it |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | Kimi report; Claude-Code harness, max effort |
| Claude Opus 5.5 | 66.4% | Public result cited by Kimi |
| GPT-6 Astra | 58.2% | Public result cited by Kimi |
| DeepSeek V4.1 Flash-1017 | 42.3% | DeepSeek model card; Claude Code harness |
The Kimi technical report says competitor scores use the highest value in their announcements or the official leaderboard. This is not a controlled experiment with equal costs and reasoning budgets. The DeepSeek model card reports 77.0 on a different evaluation, DeepSWE v1.1; that cannot be mixed with Terminal-Bench scores to create a ranking.
For real work, define success for each task: Korean document summarization, structured JSON, repository changes or evidence retrieval in long documents. A coding benchmark does not establish Korean writing quality, chart comprehension or understanding of your company's repository. Tools, runtime, effort and context also affect results.
Compare candidates on 30–50 public examples, recording correctness, citation errors, test passes, 95th-percentile latency, retries and human editing time. Cost per accepted result is total API spend divided by the number of outputs that pass review.
7. Security: apps, APIs and self-hosting have different terms
Country of origin alone does not determine safety. Review what you send to which service, where it is stored, and how it is used for training and logging. Payment does not itself guarantee no training or no retention.
| Usage path | What official documentation establishes | What to check for work |
|---|---|---|
| General Kimi service | General privacy policy describes storage in China, model improvement using de-identified input/output, and a way to request an opt-out | Distinguish personal subscriptions from business API terms |
| Kimi API | Separate help page says API input/output is not used to train or improve models; K3.1 announcement offers ZDR | Verify residency, log retention and ZDR eligibility for the actual contract and endpoint |
| Direct DeepSeek service | Policy describes processing/storage in China, improvement and training purposes, and opt-out rights | We did not confirm an API-wide no-training or zero-retention guarantee in the public documents reviewed |
| OpenAI API | No training by default; default abuse-monitoring logs may last up to 30 days, with separate feature-specific state storage | store=false does not remove every log; check ZDR eligibility and features |
| Claude API | Commercial API does not train by default; standard inputs/outputs are generally deleted within 30 days, with exceptions | Check Files, safety investigations, legal retention, model-specific exceptions and contracts |
Sources: Kimi general policy, Kimi API security, K3.1 availability, DeepSeek policy, OpenAI data controls, Claude training policy, Claude retention policy.
Do not extend Kimi's API no-training statement to its general chat app, or conclude that every DeepSeek API input must be trained on merely because a guarantee was not found. No training, ZDR and data residency are different properties. Nor should personal ChatGPT or Claude plans be assumed to have the same commercial terms as their APIs.
Self-hosting is another option. DeepSeek Flash-1017's official model card provides weights under the MIT license. However, full Kimi K3.1 Pro weights were scheduled for release by November 4 as of the review date. It would be inaccurate to promise immediate self-hosting of that same model. Even after release, assess licensing, GPU and memory needs, inference software and operating costs.
Running inference internally can reduce transfers to external model APIs, but remote search, tools and telemetry may create other data flows. An API intermediary requires checking both its policy and the actual inference provider's policy. Prompt injection, incorrect tool actions and key leakage remain possible with any model.
8. Adoption: measure cost and quality on a small workload
- Classify the data. Start with public documents and synthetic data. Use customer information, credentials and unpublished source only after the organization has approved the processing route and contractual conditions.
- Fix the evaluation task. For example, summarize 50 public release notes into the same JSON schema. Invented dates or features count as failures.
- Record models and conditions. Log actual response models such as
deepseek-flashandkimi-k3.1-pro, effort, tokens, cache usage, time period and errors. Keep API keys in server-side secret storage or environment variables. - Escalate after validation. Use observable failures such as malformed JSON, missing sources or failing tests. A model's own expression of confidence should not be the sole retry criterion.
- Review total cost after a week. Include API bills, premium-model reprocessing, human editing, latency and operating overhead. Expand tasks that meet quality and data requirements.
In the monthly example, processing everything with peak-rate Flash and rerunning 20% on Sol or Sonnet at the same length costs $5.40 + $8 = $13.40, 66.5% below starting with $40 of Sol/Sonnet calls. This is an operational scenario, not a measured success rate. Validation calls, extra context and search reduce the savings.
For an individual, time saved in a familiar app can matter more than a $1 monthly difference. Development teams can evaluate DeepSeek for volume work and compare Kimi, GPT and Claude on the same harder tasks. Include Luna and Haiku for repetitive classification. The practical objective is the lowest total cost for outputs that meet quality and data requirements, rather than the cheapest token.
使用 Kimi 和 DeepSeek,能比 ChatGPT、Claude 节省多少费用?本文分别比较海外订阅价格与最新 API 单价,计算相同 token 用量的成本,并讨论性能评测条件、数据训练与存储政策,以及实际业务中的采用方法。
信息核实日期为 2026 年 10 月 24 日。价格采用官方公开页面显示的美元金额,不计税费、汇率和支付渠道差异。费用属于计算示例,并非实际调用 API 或自行运行性能基准测试的结果。
1. 先区分应用订阅与模型 API
Kimi 是 Moonshot AI 的聊天、文档与编程产品系列;DeepSeek 提供免费聊天应用、付费模型 API 等产品。ChatGPT 和 Claude 同样需要区分应用订阅与开发者 API。品牌相同,并不意味着计费对象和用量规则相同。
订阅购买的是应用功能、编程工具、文件处理、集成服务和一定使用额度。API 则按自己的应用或自动化调用模型的用量付费。每月 20 美元的应用订阅,不能直接与每百万 token 2 美元的 API 比较。即使套餐都叫 Plus 或 Pro,各公司的功能和额度也不同。
2. 订阅费:Kimi 海外 Plus 便宜 5%
下表是公开海外美元页面显示的个人套餐价格。月付价格与年付折算月价分开列出。
| 服务 | 月付 | 年付或更高套餐 | 如何理解 |
|---|---|---|---|
| Kimi Plus | $19 | 每年 $180,折合每月 $15 | 比月付 ChatGPT Plus、Claude Pro 少 $1,即 5% |
| Kimi Pro / Max / Ultra | $39 / $99 / $199 | 每年 $372 / $948 / $1,908 | 名称相似不代表跨厂商额度相同 |
| DeepSeek 官方应用 | 免费 | 应用与付费 API 分开 | 可先用来评估日常聊天 |
| ChatGPT Go / Plus | $8 / $20 | Pro 为 $100 / $200 / $500 | Go 与 Plus 的模型及功能也不同 |
| Claude Pro | $20 | 每年 $200 | 按年付总价计算,Kimi Plus 便宜 10% |
| Claude Max | $100 起 | 5x / 20x 用量套餐 | 也应考虑其 API 额度 |
来源:Kimi 海外订阅页面、DeepSeek 官方免费应用说明、ChatGPT 价格、Claude 价格。
官方公开订阅页选择 Monthly 后显示的美元价格。截图日期:2026-10-24。来源 · 查看原图。
搜索中出现的 Kimi Go ¥49、Plus ¥99 属于中国境内套餐说明。将其换算后当作韩国用户的海外订阅价格,会造成误导。上表反映核实当时的海外页面,具体可购买套餐和最终费用仍以自己的账号结算页面为准。
比较免费服务时,也要记得 ChatGPT 和 Claude 都有免费套餐。只把免费 DeepSeek 与其他公司的最高价套餐放在一起计算节省比例,并不能说明功能或用量差异。Kimi 也有共享月度额度和 Kimi Code 使用限制,月费并不意味着无限使用。(Kimi 用量规则)
3. API 单价:最新 Kimi 与中档 GPT、Claude 相同
单位为每百万 token 的美元价格。OpenAI 使用 Standard、短上下文档位;Haiku 对应提示词不超过 10 万 token 的档位。输入列指缓存未命中,输出列包括全部计费输出,缓存命中输入另列。
| 模型 / 时段 | 输入 | 输出 | 缓存命中输入 |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017 / 高峰 | $0.30 | $1.20 | $0.006 |
| DeepSeek V4.1 Flash-1017 / 非高峰 | $0.15 | $0.60 | $0.003 |
| DeepSeek V4 Pro-0813 / 高峰 | $1.32 | $3.96 | $0.044 |
| DeepSeek V4 Pro-0813 / 非高峰 | $0.66 | $1.98 | $0.022 |
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Luna / Claude Haiku 5.5 | $0.10 | $0.50 | $0.01 |
来源:DeepSeek 价格表、Kimi 价格表、OpenAI API 价格表、Claude API 价格表。
K3.1 Pro 的基础输入、输出单价与 Sol、Sonnet 相同,是 Opus 的一半,但缓存命中输入比 Sol、Sonnet 贵。Highspeed 有独立价格,不能套用普通版本的单价。只用旧 K2 价格解释所有最新 Kimi 模型也不准确:官方文档宣布,10 月 31 日起停止向新用户提供 K2,计划在 12 月底完全退役。
官方 API 价格表中的 K3.1 Pro 与 Highspeed 部分。这是独立于订阅的按量计费,缓存写入也单独列示。截图日期:2026-10-24。来源 · 查看原图。
DeepSeek 高峰时段为周一至周五 UTC 01–04 时、06–10 时,中国法定节假日除外。换算成韩国时间是工作日 10–13 时、15–19 时,其他时间为非高峰。Flash 使用模型 ID deepseek-flash,Pro 使用 deepseek-v4-pro。名称带 Pro 不代表所有功能更强:当前价格表仅列出 Flash 支持图片输入。
4. 相同用量,实际计算相差多少
假设每月调用 1 万次,每次输入 1,000 token、计费输出 200 token,总计输入 1,000 万、输出 200 万 token。不计重试、工具、存储和税费,输入缓存命中率为零。OpenAI、Claude 不使用缓存写入;Kimi 默认五分钟写入价格与普通输入相同。
cost_usd = input_tokens / 1_000_000 * input_rate
         + output_tokens / 1_000_000 * output_rate
saving_pct = (1 - candidate_cost / baseline_cost) * 100
| 模型 / 时段 | 每月计算费用 | 相比 Sol、Sonnet $40 节省 | 相比 Opus $80 节省 |
|---|---|---|---|
| DeepSeek Flash 高峰 | $5.40 | 86.5% | 93.25% |
| DeepSeek Flash 非高峰 | $2.70 | 93.25% | 96.63% |
| DeepSeek Pro 高峰 | $21.12 | 47.2% | 73.6% |
| DeepSeek Pro 非高峰 | $10.56 | 73.6% | 86.8% |
| Kimi K3.1 Pro | $40 | 0% | 50% |
| Kimi Highspeed / Claude Opus 5.5 | $80 | 不节省,费用为 2 倍 | 0% |
| GPT-6.1 Sol / Claude Sonnet 5.5 | $40 | 0% | 50% |
| GPT-6 Luna / Claude Haiku 5.5 | $2 | 95% | 97.5% |
| GPT-6 Astra | $200 | 不节省,费用为 5 倍 | 不节省,费用为 2.5 倍 |
这是相同 token 数量下的价格比较。同一个请求在不同模型中,分词方式、推理长度与重试次数可能不同,实际账单也会变化。如果 Luna、Haiku 能满足分类和提取任务的质量要求,费用甚至低于 DeepSeek Flash。应先确定任务所需的模型档位,再考虑其来源国家。
5. 缓存、推理和订阅额度会改变节省比例
反复发送长文档时,缓存很重要,但不能用最低缓存命中价格乘以全部输入。应区分命中、未命中和写入 token,并计入 TTL 与首个请求。Kimi K3.1 Pro 五分钟写入为 $2,一小时为 $4;缓存文档说明,读取、写入和其余输入是互不重叠的计费分类。
推理模型的计费输出 token 可能多于屏幕上可见的答案。本例的 200 token 假设包含全部计费输出。智能体重新读取文件、调用工具或重试失败任务,也会增加请求。适合 OpenAI Flex/Batch、Claude Batch 的工作负载可以获得折扣。还应合计搜索、执行环境和存储费用。
订阅与 API 是不同产品,但当前 Claude Max 包含 API 额度:Max 5x 每月 $100,Max 20x 每月 $200,合资格账号需要关联 Console 组织领取。新订阅者七天后可领取,未使用额度不结转,也不能用于 Claude Code 或应用额外用量。(官方额度说明)
如果已经因工作订阅 Max,并有剩余合资格额度,运行表中 $80 的 API 工作负载,新增现金支出可能为零,但订阅本身仍然收费。应分别计算保留现有订阅时的增量支出,以及新购订阅时的总支出。
6. 性能:具有竞争力,但不能压缩成单一排名
最新公开评测并不支持把 Kimi、DeepSeek 仅视为低性能替代品。不过,下表来自提供商发布及其引用的结果,并非本文在相同环境下重新测试所得。
| Terminal-Bench 4.0 模型 | 公开分数 | 如何阅读 |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | Kimi 发布,Claude-Code harness、max effort |
| Claude Opus 5.5 | 66.4% | Kimi 发布中引用的公开结果 |
| GPT-6 Astra | 58.2% | Kimi 发布中引用的公开结果 |
| DeepSeek V4.1 Flash-1017 | 42.3% | DeepSeek 模型卡,Claude Code harness |
Kimi 技术报告注明,竞争模型分数取其发布文章或官方排行榜中的最高值,因此并非同等成本、同等推理预算的受控实验。DeepSeek 模型卡在另一项评测 DeepSWE v1.1 中报告 77.0,不能将其与 Terminal-Bench 分数混合排名。
实际工作应针对韩语文档摘要、结构化 JSON、仓库修改、长文档证据检索等任务,分别制定成功标准。编程基准成绩不能保证韩语文风、图表理解或公司仓库理解能力。工具配置、运行时间、effort 与上下文也会改变结果。
用 30–50 个公开样例比较候选模型,同时记录正确率、引用错误、测试通过情况、第 95 百分位延迟、重试和人工修改时间,更有助于决定是否采用。每个合格结果的成本,等于 API 总费用除以通过审核的结果数量。
7. 安全:应用、API 与自行托管的条件不同
不能只凭来源国家判断安全。实际需要审查的是向哪个服务发送什么数据、存储在哪里,以及如何用于训练和日志。付费本身不保证不训练或不留存。
| 使用路径 | 官方文档确认的内容 | 工作中需要确认 |
|---|---|---|
| Kimi 一般服务 | 一般隐私政策说明中国境内存储、使用去标识化输入输出改进模型,以及拒绝申请流程 | 区分个人订阅和业务 API 条款 |
| Kimi API | 独立帮助页说明 API 输入输出不用于模型训练或改进;K3.1 发布说明提供 ZDR | 核实实际合同、端点的存储地区、日志保留和 ZDR 条件 |
| DeepSeek 直接服务 | 政策说明中国境内处理与存储、技术改进和训练目的及拒绝权利 | 在已审阅公开文档中,未确认覆盖全部 API 的不训练、零保留保证 |
| OpenAI API | 默认不用于训练;默认滥用监测日志最长 30 天,功能状态存储另计 | store=false 不会删除全部日志;确认 ZDR 资格与功能 |
| Claude API | 商业 API 默认不训练;一般输入输出原则上 30 天内删除,但存在例外 | 确认 Files、安全调查、法律保留、模型例外和单独合同 |
来源:Kimi 一般政策、Kimi API 安全说明、K3.1 提供说明、DeepSeek 政策、OpenAI 数据控制、Claude 训练政策、Claude 保留政策。
不能把 Kimi API 的不训练声明扩大到一般聊天应用,也不能因没有找到 DeepSeek 的保证,就断言每条 API 输入必然用于训练。不训练、ZDR 与存储地区是不同条件。ChatGPT、Claude 的个人套餐也不能被假定适用与商业 API 相同的政策。
自行托管是另一种选择。DeepSeek Flash-1017 的官方模型卡提供 MIT 许可权重;但截至核实日期,Kimi K3.1 Pro 完整权重计划于 11 月 4 日前公开,不能说现在即可自行部署同一模型。发布之后仍须评估许可证、GPU、内存、推理引擎和运营成本。
在组织内部进行推理,可以减少向外部模型 API 发送数据,但远程搜索、工具和遥测仍可能形成其他传输路径。使用中转 API 时,应同时检查中转商与实际推理提供商的政策。任何模型都可能面临提示词注入、错误工具操作和密钥泄露。
8. 实际采用:从小任务开始同时记录成本与质量
- 分类数据。 先使用公开文档和合成数据。客户信息、认证密钥和未公开源码,须在组织批准处理路径并确认合同条件后使用。
- 固定评估任务。 例如把 50 篇公开发布说明总结成同一种 JSON schema。编造原文没有的日期或功能,判定为失败。
- 记录模型与条件。 记录
deepseek-flash、kimi-k3.1-pro等实际响应模型、effort、token、缓存、时段与错误。API 密钥保存在服务端秘密存储或环境变量中。 - 验证后再交给更强模型。 使用 JSON 格式错误、缺少来源、测试失败等可核查条件,不只依赖模型自己表达的信心。
- 一周后按总成本判断。 合计 API 账单、更强模型重处理、人工修改时间、延迟与运维负担。从满足质量和数据要求的任务逐步扩大。
在前述月用量示例中,全部先交给高峰价 Flash,再将 20% 按相同长度交给 Sol、Sonnet 重做,费用为 $5.40 + $8 = $13.40,比直接花 $40 少 66.5%。这是运营方案的计算示例,不是实测成功率。验证调用、额外上下文和搜索费用会降低节省幅度。
对个人用户而言,熟悉的应用节省的时间,可能比每月 1 美元更重要。开发团队可评估 DeepSeek 的批量处理,在困难任务上用相同测试集比较 Kimi、GPT、Claude;重复分类也应考虑 Luna、Haiku。实用目标是以最低总成本得到满足质量和数据条件的结果,而非单纯寻找最便宜的 token。
KimiやDeepSeekを使うと、ChatGPT・Claudeよりどの程度節約できるのでしょうか。海外向けサブスクリプションと最新API単価を分け、同じトークン量で費用を計算します。性能評価の条件、データの学習・保存方針、実際の業務への導入方法も確認します。
情報の確認日は 2026年10月24日 です。価格は公式公開ページの米ドル表示で、税金・為替・決済経路による差は含みません。費用は計算例であり、実際のAPI呼び出しや独自の性能ベンチマークの結果ではありません。
1. アプリの契約とモデルAPIを分ける
Kimi はMoonshot AIの会話・文書・コーディング製品群です。DeepSeek は無料のチャットアプリや有料モデルAPIなどを提供しています。ChatGPT と Claude でも、アプリの契約と開発者APIは分けて考えます。同じブランド名でも課金対象や使用量の計算は異なります。
サブスクリプションはアプリ機能、コーディングツール、ファイル処理、連携サービスと一定の使用枠をまとめて購入するものです。APIは自作アプリや自動化からモデルを呼び出した量に応じて支払います。月20ドルのアプリと100万トークン2ドルのAPIは直接比較できません。Plus・Proという名称も、会社ごとに機能と使用枠が違います。
2. 月額料金:海外向けKimi Plusは5%安い
以下は公開された海外向けUSDページの個人料金です。月払いと年払いの月額換算を区別しています。
| サービス | 月払い | 年払い・上位プラン | 読み方 |
|---|---|---|---|
| Kimi Plus | $19 | 年$180、月換算$15 | ChatGPT Plus・Claude Proの月払いより$1、5%安い |
| Kimi Pro / Max / Ultra | $39 / $99 / $199 | 年$372 / $948 / $1,908 | 同じような名称でも他社と使用枠が同等とは限らない |
| DeepSeek公式アプリ | 無料 | アプリと有料APIは別 | 日常の会話から評価できる |
| ChatGPT Go / Plus | $8 / $20 | Proは$100 / $200 / $500 | GoとPlusもモデル・機能が異なる |
| Claude Pro | $20 | 年$200 | 年額ではKimi Plusが10%安い |
| Claude Max | $100から | 5x / 20xの使用枠 | 付属するAPIクレジットも考慮 |
出典:Kimi海外向け契約ページ、DeepSeek無料アプリの公式案内、ChatGPT料金、Claude料金。
公式公開ページでMonthlyを選んだUSD表示。2026-10-24撮影。出典 · 画像を大きく表示。
検索で見かけるKimi Go ¥49、Plus ¥99は中国国内の料金案内です。それを換算して韓国ユーザーの海外契約料金として紹介すると誤った比較になります。表は確認時の海外向け表示であり、購入できるプランと最終金額は自分のアカウントの決済画面で確認します。
無料利用を比較するなら、ChatGPT・Claudeにも無料プランがあります。無料DeepSeekと他社の最高額プランだけを並べて節約率を出しても、機能や使用量の比較にはなりません。Kimiにも月間共有クレジットとKimi Codeの使用制限があり、月額を払えば無制限とは解釈できません。(Kimiの使用量ルール)
3. API単価:最新Kimiは中位のGPT・Claudeと同じ
単位は 100万トークン当たりUSD です。OpenAIはStandard・短いコンテキスト、Haikuはプロンプト10万トークン以下の区分です。入力はキャッシュ未命中、出力は課金対象の出力全体を指し、キャッシュ命中入力は別列にしています。
| モデル・料金時間帯 | 入力 | 出力 | キャッシュ命中入力 |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017 / ピーク | $0.30 | $1.20 | $0.006 |
| DeepSeek V4.1 Flash-1017 / オフピーク | $0.15 | $0.60 | $0.003 |
| DeepSeek V4 Pro-0813 / ピーク | $1.32 | $3.96 | $0.044 |
| DeepSeek V4 Pro-0813 / オフピーク | $0.66 | $1.98 | $0.022 |
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Luna / Claude Haiku 5.5 | $0.10 | $0.50 | $0.01 |
出典:DeepSeek料金表、Kimi料金表、OpenAI API料金表、Claude API料金表。
K3.1 Proの基本入力・出力単価はSol・Sonnetと同じで、Opusの半額です。一方、キャッシュ命中入力はSol・Sonnetより高くなります。Highspeedは別料金なので通常モデルの単価を使えません。古いK2の価格だけで最新Kimi全体を安いと説明するのも不正確です。公式文書は10月31日から新規ユーザーへのK2提供を終了し、12月末の全面廃止を予定しています。
公式API料金表のK3.1 Pro・Highspeed部分。契約料金とは別の従量課金で、キャッシュ書き込みも区別されています。2026-10-24撮影。出典 · 画像を大きく表示。
DeepSeekのピーク時間は、中国の祝日を除く月〜金のUTC 01〜04時、06〜10時です。韓国時間では 平日10〜13時、15〜19時 で、それ以外がオフピークです。モデルIDはFlashが deepseek-flash、Proが deepseek-v4-pro。Proという名称がすべての機能の上位を意味するわけではなく、現在の表では画像入力に対応するのはFlashだけです。
4. 同じ使用量ならいくら違うのか
月1万回、各回で入力1,000トークン・課金出力200トークンを使うと仮定します。合計は 入力1,000万・出力200万トークン。再試行・ツール・保存費・税金はなく、入力キャッシュ命中はゼロです。OpenAI・Claudeではキャッシュ書き込みを使わず、Kimiの標準5分書き込み単価は通常入力と同じです。
cost_usd = input_tokens / 1_000_000 * input_rate
         + output_tokens / 1_000_000 * output_rate
saving_pct = (1 - candidate_cost / baseline_cost) * 100
| モデル・時間帯 | 月間計算額 | Sol・Sonnetの$40比削減 | Opusの$80比削減 |
|---|---|---|---|
| DeepSeek Flashピーク | $5.40 | 86.5% | 93.25% |
| DeepSeek Flashオフピーク | $2.70 | 93.25% | 96.63% |
| DeepSeek Proピーク | $21.12 | 47.2% | 73.6% |
| DeepSeek Proオフピーク | $10.56 | 73.6% | 86.8% |
| Kimi K3.1 Pro | $40 | 0% | 50% |
| Kimi Highspeed / Claude Opus 5.5 | $80 | 削減なし、費用は2倍 | 0% |
| GPT-6.1 Sol / Claude Sonnet 5.5 | $40 | 0% | 50% |
| GPT-6 Luna / Claude Haiku 5.5 | $2 | 95% | 97.5% |
| GPT-6 Astra | $200 | 削減なし、費用は5倍 | 削減なし、費用は2.5倍 |
これは 同じトークン数での価格比較 です。同じ依頼でもトークナイザー、推論の長さ、再試行数が違えば請求額も変わります。分類・抽出でLuna・Haikuが品質要件を満たすなら、DeepSeek Flashよりも安くなります。国籍より先に、仕事に必要なモデルの等級を決めるべきです。
5. キャッシュ・推論・契約クレジットで節約率は変わる
長い文書を繰り返し送る処理ではキャッシュが重要ですが、すべての入力に最安の命中単価を掛けてはいけません。命中・未命中・書き込みを分け、TTLと初回リクエストも含めます。Kimi K3.1 Proは5分書き込みが$2、1時間が$4で、キャッシュ文書は読み込み・書き込み・残りの入力を重複しない区分と説明しています。
推論モデルは画面に見える回答より多くの課金出力トークンを使うことがあります。例の200トークンは、その全体を含む仮定です。ファイルの再読込、ツール呼び出し、失敗の再試行でもリクエストは増えます。OpenAI Flex/BatchやClaude Batchに適する仕事なら割引も利用できます。検索・実行環境・保存料を含めて比較します。
契約とAPIは別商品ですが、現在のClaude MaxにはAPIクレジット特典があります。Max 5xは月$100、Max 20xは$200で、対象アカウントからConsole組織を接続して受け取ります。新規契約者は7日後から申請でき、未使用分は繰り越されません。Claude Codeやアプリの追加使用量には適用されません。(公式クレジット案内)
すでに業務でMaxを契約し、対象クレジットが余っていれば、表のAPI $80相当の仕事を追加の現金支出ゼロで処理できる場合があります。契約料がなくなるわけではありません。既存契約を維持する場合の追加支出と、新規契約する場合の総支出を別々に計算します。
6. 性能:競争力はあるが単一順位にはできない
最新の公開評価を見ると、Kimi・DeepSeekを単なる低性能な代替品とみなすのは適切ではありません。ただし下表は提供会社の発表とその引用値であり、この記事が同じ環境で再測定した結果ではありません。
| Terminal-Bench 4.0のモデル | 公開スコア | 読み方 |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | Kimi発表、Claude-Code harness・max effort |
| Claude Opus 5.5 | 66.4% | Kimi発表が引用した公開結果 |
| GPT-6 Astra | 58.2% | Kimi発表が引用した公開結果 |
| DeepSeek V4.1 Flash-1017 | 42.3% | DeepSeekモデルカード、Claude Code harness |
Kimiの技術報告は、競合モデルのスコアを発表記事または公式ランキングの最大値から取得したと明記しています。同じ費用・推論予算の統制実験ではありません。DeepSeekモデルカードは別評価のDeepSWE v1.1で77.0を報告していますが、Terminal-Benchの値と混ぜて順位は作れません。
実務では、韓国語文書の要約、構造化JSON、リポジトリ修正、長文からの根拠検索など、仕事別に成功条件を決めて評価します。コーディング評価は韓国語の文体、図表理解、社内リポジトリの理解まで保証しません。ツール構成、実行時間、effort、コンテキストも結果を変えます。
公開データ30〜50件で候補を比べ、正答率、引用の誤り、テスト合格、95パーセンタイル遅延、再試行と人の修正時間を記録すると判断に役立ちます。合格結果1件当たりの費用は、API総額をレビュー通過件数で割って求めます。
7. 安全性:アプリ・API・自前運用で条件が違う
出身国だけで安全性は判断できません。確認すべきは どのサービスに何を送り、どこに保存され、学習やログにどう使われるか です。有料というだけでは、学習不使用や無保存は保証されません。
| 利用経路 | 公式文書で確認したこと | 業務導入で確認する点 |
|---|---|---|
| Kimi一般サービス | 一般ポリシーは中国内保存、匿名化処理した入出力によるモデル改善、拒否申請手順を説明 | 個人契約と業務APIの条件を区別 |
| Kimi API | 専用ヘルプはAPI入出力を学習・改善に使わないと明記。K3.1発表はZDR提供を案内 | 実契約・エンドポイントの保存地域、ログ保管、ZDR適用条件 |
| DeepSeek直接サービス | 中国内処理・保存、技術改善・学習の目的、拒否の権利を明記 | 調べた公開文書ではAPI全体の学習不使用・無保存保証を確認できなかった |
| OpenAI API | 標準で学習不使用。標準の不正利用監視ログは最大30日、機能別の状態保存は別 | store=falseだけで全ログは消えない。ZDR資格・対応機能を確認 |
| Claude API | 商用APIは標準で学習不使用。通常の入出力は原則30日以内に削除、例外あり | Files、安全調査、法的保存、モデル別の例外、契約を確認 |
出典:Kimi一般ポリシー、Kimi APIセキュリティ、K3.1提供案内、DeepSeekポリシー、OpenAIデータ制御、Claude学習方針、Claude保存方針。
Kimi APIの学習不使用の説明を一般チャットへ広げたり、DeepSeekの保証が見つからないことから全API入力が必ず学習されると断定したりしてはいけません。学習不使用、ZDR、保存地域は別条件です。ChatGPT・Claudeの個人プランも商用APIと同じ方針とは仮定しません。
自前運用も選択肢です。DeepSeek Flash-1017は公式モデルカードでMITライセンスの重みを提供しています。一方、確認日時点でKimi K3.1 Proの全重みは11月4日までの公開予定であり、今すぐ同じモデルを自前で運用できるとは案内できません。公開後もライセンス、GPU・メモリ、推論エンジンと運用費を検討します。
組織内で推論すれば外部モデルAPIへの送信は減らせますが、リモート検索、ツール、テレメトリーがあれば別の送信経路が生まれます。中継APIでは中継事業者と実際の推論事業者の両方の方針を確認します。どのモデルでもプロンプトインジェクション、誤ったツール操作、キー流出の可能性は残ります。
8. 実際の導入:小さな仕事から費用と品質を記録する
- データを分類する。 公開文書・合成データから始めます。顧客情報、認証キー、未公開ソースは組織が承認した処理経路と契約を確認してから使います。
- 評価タスクを固定する。 例えば公開リリースノート50件を同じJSONスキーマで要約し、原文にない日付・機能を作ったら失敗とします。
- モデルと条件を記録する。
deepseek-flash、kimi-k3.1-proなど実際の応答モデル、effort、トークン、キャッシュ、時間帯、エラーを残します。APIキーはサーバーの秘密情報ストアや環境変数に保存します。 - 検証してから上位モデルへ送る。 JSONエラー、出典不足、テスト失敗など確認可能な条件を使い、モデル自身の自信だけで再試行を決めません。
- 1週間後に総費用で判断する。 API請求、上位モデルでの再処理、人の修正時間、遅延、運用負担を合算し、品質とデータ要件を満たす仕事から広げます。
上の月間例で全件をピーク料金のFlashで処理し、20%を同じ長さでSol・Sonnetへ再依頼すると、$5.40 + $8 = $13.40。最初から$40を使う場合より66.5%安くなります。これは運用設計の計算例で、実測成功率ではありません。検証呼び出し、追加コンテキスト、検索費が増えれば削減幅は小さくなります。
個人には、慣れたアプリで節約する時間が月1ドルの差より大きい場合があります。開発チームは大量処理でDeepSeekを検討し、難しい仕事ではKimi・GPT・Claudeを同じ評価セットで比較できます。反復分類にはLuna・Haikuも候補です。実用的な目標は、品質とデータ条件を満たす成果を最小の総費用で得る組み合わせを探すことです。
¿Cuánto permiten ahorrar Kimi y DeepSeek frente a ChatGPT y Claude? Esta guía separa las suscripciones internacionales de las tarifas API actuales, calcula costes para el mismo volumen de tokens y analiza las condiciones de evaluación, las políticas de entrenamiento y almacenamiento y la adopción práctica.
La información se comprobó el 24 de octubre de 2026. Los precios son importes públicos en USD, sin impuestos, conversión de divisas ni diferencias del canal de pago. Los costes son ejemplos calculados, no resultados de llamadas reales a las API ni de pruebas de rendimiento propias.
1. Separar la suscripción de la aplicación de la API
Kimi es la familia de productos de conversación, documentos y programación de Moonshot AI. DeepSeek ofrece, entre otros productos, una aplicación gratuita de conversación y API de pago. En ChatGPT y Claude también hay que distinguir la suscripción de la aplicación de la API para desarrolladores. Compartir marca no implica compartir facturación.
Una suscripción reúne funciones de la aplicación, herramientas de programación, archivos, integraciones y una cuota de uso. La API cobra por las llamadas que realizan tus propias aplicaciones o automatizaciones. Una aplicación de 20 dólares al mes no se puede comparar directamente con una API de 2 dólares por millón de tokens. Incluso nombres como Plus o Pro representan capacidades y cuotas diferentes según la empresa.
2. Suscripciones: Kimi Plus internacional cuesta un 5% menos
Estos son los precios individuales mostrados en páginas públicas internacionales en USD. Se distingue la facturación mensual del equivalente mensual de una contratación anual.
| Servicio | Pago mensual | Pago anual o planes superiores | Interpretación |
|---|---|---|---|
| Kimi Plus | $19 | $180/año, equivalente a $15/mes | $1 o 5% menos que ChatGPT Plus y Claude Pro con pago mensual |
| Kimi Pro / Max / Ultra | $39 / $99 / $199 | $372 / $948 / $1,908 al año | Nombres parecidos no implican cuotas equivalentes entre proveedores |
| Aplicación oficial DeepSeek | Gratis | Aplicación y API de pago separadas | Permite empezar evaluando conversaciones cotidianas |
| ChatGPT Go / Plus | $8 / $20 | Pro de $100 / $200 / $500 | Go y Plus también difieren en modelos y funciones |
| Claude Pro | $20 | $200/año | Por total anual, Kimi Plus cuesta un 10% menos |
| Claude Max | Desde $100 | Planes de uso 5x / 20x | Conviene incluir sus créditos API en el cálculo |
Fuentes: suscripciones internacionales de Kimi, aplicación gratuita oficial de DeepSeek, precios de ChatGPT, precios de Claude.
Página pública oficial con Monthly seleccionado y precios en USD. Captura del 24-10-2026. Fuente · Ver imagen completa.
Los precios Kimi Go ¥49 y Plus ¥99 que aparecen en búsquedas corresponden a la documentación de planes de China. Convertirlos y presentarlos como precios internacionales para usuarios de Corea sería engañoso. La tabla refleja la página internacional al comprobarla; los planes disponibles y el importe final deben verificarse en la pantalla de pago de cada cuenta.
ChatGPT y Claude también tienen planes gratuitos. Comparar DeepSeek gratuito únicamente con los planes más caros de otros proveedores no compara funciones ni uso. Kimi dispone de créditos mensuales compartidos y límites específicos de Kimi Code, por lo que pagar una cuota mensual no significa uso ilimitado. (Reglas de uso de Kimi)
3. API: el Kimi actual iguala las tarifas intermedias de GPT y Claude
Todos los importes son USD por millón de tokens. OpenAI corresponde a Standard con contexto corto; Haiku, a prompts de hasta 100.000 tokens. La entrada supone fallo de caché, la salida incluye toda la salida facturable y la entrada en caché figura por separado.
| Modelo / franja | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017 / punta | $0.30 | $1.20 | $0.006 |
| DeepSeek V4.1 Flash-1017 / valle | $0.15 | $0.60 | $0.003 |
| DeepSeek V4 Pro-0813 / punta | $1.32 | $3.96 | $0.044 |
| DeepSeek V4 Pro-0813 / valle | $0.66 | $1.98 | $0.022 |
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6 Luna / Claude Haiku 5.5 | $0.10 | $0.50 | $0.01 |
Fuentes: tarifas de DeepSeek, tarifas de Kimi, OpenAI API, Claude API.
La entrada y salida básicas de K3.1 Pro cuestan lo mismo que Sol y Sonnet, y la mitad que Opus. Sin embargo, su entrada en caché es más cara que la de Sol y Sonnet. Highspeed tiene tarifas propias: no se le puede aplicar el precio de la versión normal. Tampoco es correcto describir todo Kimi actual mediante tarifas antiguas de K2. La documentación anuncia el fin del acceso a K2 para usuarios nuevos el 31 de octubre y su retirada total a finales de diciembre.
Sección K3.1 Pro y Highspeed de la tabla oficial API. Es facturación por uso independiente de la suscripción, con partidas de escritura de caché separadas. Captura del 24-10-2026. Fuente · Ver imagen completa.
Las horas punta de DeepSeek son de lunes a viernes, salvo festivos chinos, de 01:00 a 04:00 y de 06:00 a 10:00 UTC. En Corea equivalen a 10:00–13:00 y 15:00–19:00 entre semana; el resto es horario valle. Los identificadores son deepseek-flash y deepseek-v4-pro. La etiqueta Pro no implica superioridad en todas las funciones: la tabla actual solo atribuye entrada de imágenes a Flash.
4. Cuánto cuesta realmente el mismo volumen
Supongamos 10.000 llamadas al mes, cada una con 1.000 tokens de entrada y 200 de salida facturable: 10 millones de entrada y 2 millones de salida en total. No hay reintentos, herramientas, almacenamiento ni impuestos, y no se producen aciertos de caché. No se usan escrituras de caché en OpenAI ni Claude; la escritura predeterminada de cinco minutos de Kimi cuesta lo mismo que su entrada normal.
cost_usd = input_tokens / 1_000_000 * input_rate
         + output_tokens / 1_000_000 * output_rate
saving_pct = (1 - candidate_cost / baseline_cost) * 100
| Modelo / franja | Coste mensual calculado | Ahorro frente a Sol/Sonnet de $40 | Ahorro frente a Opus de $80 |
|---|---|---|---|
| DeepSeek Flash punta | $5.40 | 86.5% | 93.25% |
| DeepSeek Flash valle | $2.70 | 93.25% | 96.63% |
| DeepSeek Pro punta | $21.12 | 47.2% | 73.6% |
| DeepSeek Pro valle | $10.56 | 73.6% | 86.8% |
| Kimi K3.1 Pro | $40 | 0% | 50% |
| Kimi Highspeed / Claude Opus 5.5 | $80 | Sin ahorro; coste 2× | 0% |
| GPT-6.1 Sol / Claude Sonnet 5.5 | $40 | 0% | 50% |
| GPT-6 Luna / Claude Haiku 5.5 | $2 | 95% | 97.5% |
| GPT-6 Astra | $200 | Sin ahorro; coste 5× | Sin ahorro; coste 2.5× |
Es una comparación de precios para la misma cantidad de tokens. La misma petición puede generar diferente tokenización, razonamiento y número de reintentos, alterando la factura. Si Luna o Haiku cumplen los requisitos de clasificación o extracción, cuestan menos incluso que DeepSeek Flash. Primero hay que elegir la categoría de modelo que necesita la tarea, antes de considerar su país de origen.
5. Caché, razonamiento y créditos cambian el ahorro
La caché importa cuando se envían documentos largos repetidamente, pero no debe multiplicarse toda la entrada por la tarifa mínima de caché. Hay que separar lecturas, fallos y escrituras, incluyendo TTL y la primera petición. Kimi K3.1 Pro cobra $2 por escrituras de cinco minutos y $4 por una hora; su documentación de caché describe lectura, escritura y entrada restante como categorías sin solapamiento.
Los modelos de razonamiento pueden generar más tokens de salida facturables que los visibles en la respuesta. Los 200 del ejemplo incluyen toda la salida facturable. Los agentes acumulan peticiones al releer archivos, utilizar herramientas o repetir tareas fallidas. OpenAI Flex/Batch y Claude Batch pueden reducir costes en cargas compatibles. También hay que sumar búsqueda, entornos de ejecución y almacenamiento.
Suscripción y API son productos distintos, pero Claude Max incluye actualmente créditos API: $100 mensuales en Max 5x y $200 en Max 20x, que se solicitan vinculando una organización de Console a una cuenta elegible. Los nuevos suscriptores pueden solicitarlos después de siete días; no se acumulan para el siguiente periodo. No cubren Claude Code ni el uso adicional de las aplicaciones. (Guía oficial de créditos)
Si ya pagas Max por trabajo y tienes créditos elegibles disponibles, la carga API de $80 del ejemplo podría no requerir desembolso adicional. La suscripción sigue teniendo coste. Calcula por separado el gasto incremental al conservar un plan y el coste total al contratar uno nuevo.
6. Rendimiento: competitivo, pero sin una clasificación universal
Las evaluaciones públicas recientes no justifican tratar a Kimi y DeepSeek simplemente como alternativas de bajo rendimiento. Sin embargo, estas cifras proceden de publicaciones de proveedores y resultados citados por ellos, no de una repetición propia en condiciones iguales.
| Modelo en Terminal-Bench 4.0 | Puntuación pública | Cómo interpretarla |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | Publicación de Kimi; Claude-Code harness y max effort |
| Claude Opus 5.5 | 66.4% | Resultado público citado por Kimi |
| GPT-6 Astra | 58.2% | Resultado público citado por Kimi |
| DeepSeek V4.1 Flash-1017 | 42.3% | Ficha de DeepSeek; Claude Code harness |
El informe técnico de Kimi indica que toma para sus competidores el mayor valor publicado en sus anuncios o en la clasificación oficial. No es un experimento controlado con igual coste y presupuesto de razonamiento. La ficha de DeepSeek informa de 77.0 en otra evaluación, DeepSWE v1.1; no se puede mezclar con Terminal-Bench para construir una clasificación.
En el trabajo, define criterios de éxito por tarea: resumir documentos coreanos, producir JSON, modificar repositorios o encontrar pruebas en documentos largos. Una prueba de programación no garantiza calidad de redacción coreana, comprensión de gráficos o conocimiento del repositorio de la empresa. Herramientas, tiempo de ejecución, effort y contexto también modifican el resultado.
Compara candidatos sobre 30–50 ejemplos públicos y registra precisión, errores de citas, pruebas superadas, latencia del percentil 95, reintentos y tiempo de edición humana. El coste por resultado aceptado es el gasto API total dividido por el número de resultados que pasan la revisión.
7. Seguridad: aplicaciones, API y alojamiento propio tienen condiciones diferentes
El país de origen no determina por sí solo la seguridad. Hay que revisar qué se envía a cada servicio, dónde se almacena y cómo se utiliza para entrenamiento y registros. Pagar no garantiza ausencia de entrenamiento o retención.
| Vía de uso | Qué confirma la documentación oficial | Qué revisar para el trabajo |
|---|---|---|
| Servicio general Kimi | Política general con almacenamiento en China, mejora de modelos mediante entradas y salidas desidentificadas y procedimiento de exclusión | Distinguir suscripciones personales y condiciones de API empresarial |
| Kimi API | Ayuda específica que excluye usar entradas y salidas API para entrenar o mejorar modelos; el anuncio K3.1 ofrece ZDR | Residencia, registros y requisitos ZDR del contrato y endpoint reales |
| Servicio directo DeepSeek | Política con procesamiento y almacenamiento en China, mejora y entrenamiento como finalidades y derechos de exclusión | No confirmamos una garantía de no entrenamiento o retención cero para toda la API en los documentos revisados |
| OpenAI API | Sin entrenamiento por defecto; registros de abuso predeterminados de hasta 30 días, con almacenamiento de estado según función | store=false no elimina todos los registros; revisar elegibilidad y funciones ZDR |
| Claude API | API comercial sin entrenamiento por defecto; entradas y salidas normales eliminadas generalmente en 30 días, con excepciones | Files, investigaciones de seguridad, conservación legal, excepciones por modelo y contratos |
Fuentes: política general de Kimi, seguridad de Kimi API, disponibilidad K3.1, política de DeepSeek, controles de OpenAI, entrenamiento de Claude, retención de Claude.
No debe ampliarse la declaración de no entrenamiento de Kimi API a su aplicación de conversación, ni concluir que todas las entradas de DeepSeek API se entrenan por no haber encontrado una garantía. No entrenamiento, ZDR y residencia de datos son condiciones distintas. Tampoco deben suponerse idénticas las políticas de los planes personales de ChatGPT o Claude y sus API comerciales.
El alojamiento propio es otra opción. La ficha oficial de DeepSeek Flash-1017 proporciona pesos con licencia MIT. En cambio, a la fecha de revisión, los pesos completos de Kimi K3.1 Pro estaban previstos para publicarse antes del 4 de noviembre. No sería correcto prometer que ya puede desplegarse ese mismo modelo. Incluso tras publicarse, hay que evaluar licencia, GPU, memoria, motor de inferencia y operación.
La inferencia interna puede reducir los envíos a API externas, pero la búsqueda remota, herramientas y telemetría pueden crear otras transferencias. Con una API intermediaria hay que comprobar tanto sus políticas como las del proveedor real de inferencia. Cualquier modelo sigue expuesto a inyección de prompts, acciones incorrectas de herramientas y filtraciones de claves.
8. Adopción: medir coste y calidad en una tarea pequeña
- Clasifica los datos. Empieza con documentos públicos y datos sintéticos. Usa información de clientes, credenciales o código no publicado solo tras confirmar la ruta de procesamiento aprobada y sus condiciones contractuales.
- Fija la tarea de evaluación. Por ejemplo, resume 50 notas de versión públicas con el mismo esquema JSON. Inventar fechas o funciones ausentes del original cuenta como fallo.
- Registra modelos y condiciones. Anota el modelo real de respuesta, como
deepseek-flashokimi-k3.1-pro, effort, tokens, caché, franja y errores. Guarda las claves en secretos del servidor o variables de entorno. - Escala después de validar. Utiliza fallos verificables: JSON incorrecto, fuentes ausentes o pruebas fallidas. La confianza declarada por el modelo no debe ser el único criterio de reintento.
- Evalúa el coste total tras una semana. Suma factura API, reprocesamiento con modelos superiores, corrección humana, latencia y operación. Amplía las tareas que cumplan requisitos de calidad y datos.
En el ejemplo mensual, procesarlo todo con Flash en hora punta y repetir el 20% con Sol o Sonnet a la misma longitud cuesta $5.40 + $8 = $13.40, un 66.5% menos que comenzar gastando $40. Es un escenario de operación, no una tasa de éxito medida. Las llamadas de validación, contexto adicional y búsquedas reducen el ahorro.
Para una persona, el tiempo ahorrado en una aplicación conocida puede valer más que un dólar mensual. Los equipos pueden evaluar DeepSeek para volumen y comparar Kimi, GPT y Claude con las mismas tareas difíciles. Luna y Haiku también son candidatos para clasificación repetitiva. El objetivo práctico es obtener resultados que cumplan calidad y requisitos de datos con el menor coste total, más que encontrar el token más barato.