온톨로지란 무엇인가: 실제 프로젝트의 설계·구축·검증·운영 가이드
온톨로지는 ‘세상의 모든 것을 거대한 그래프로 그리는 기술’이 아닙니다. 특정 업무에서 무엇을 같은 개념으로 볼지, 개념끼리 어떻게 연결되는지, 그 관계를 시스템이 어떤 의미로 해석할지를 합의하는 의미 모델입니다. 잘 설계하면 서로 다른 팀의 데이터가 같은 질문에 일관되게 답할 수 있습니다. 반대로 질문과 운영 책임 없이 용어만 늘리면 관리하기 어려운 사전이 됩니다.
이 글은 가상의 서비스 카탈로그를 끝까지 만드는 흐름으로 설명합니다. 목표 질문은 “어떤 서비스가 어떤 주제를 다루고, 어느 팀이 책임지는가?”입니다. 예제 주소 https://example.org/는 설명용이므로 실제 프로젝트에서는 조직이 관리하는 도메인으로 바꿔야 합니다.
먼저 구분할 것: 분류표, 데이터베이스 스키마, 온톨로지
| 도구 | 주로 답하는 질문 | 예시 |
|---|---|---|
| 분류표·택소노미 | 무엇이 무엇의 하위 항목인가? | 지원 주제 → 계정 → 로그인 |
| 데이터베이스 스키마 | 무엇을 어떤 형식으로 저장하는가? | services.owner_team_id |
| 온톨로지 | 개념과 관계가 무엇을 뜻하는가? | 서비스는 팀이 담당하고 주제를 다룬다 |
온톨로지는 데이터베이스를 대체하지 않습니다. 기존 DB·CSV·API의 데이터를 같은 의미 체계로 연결하는 계약에 가깝습니다. 단순 탐색 메뉴만 필요하다면 분류표나 SKOS로 충분할 수 있습니다. 여러 출처의 개체와 관계를 재사용·추론·질의해야 할 때 온톨로지의 비용이 정당화됩니다.
핵심 구성요소를 한 장으로 보기
RDF는 정보를 주어–술어–목적어의 세 요소(트리플)로 표현합니다. 도움말 센터 → 담당 팀 → 고객경험팀처럼 대상과 관계를 연결합니다. 대상은 IRI라는 식별자로, 이름·날짜 같은 값은 리터럴로 표현할 수 있습니다. OWL 2는 그 위에서 클래스·속성·논리적 관계를 정의하고 추론할 수 있게 합니다.
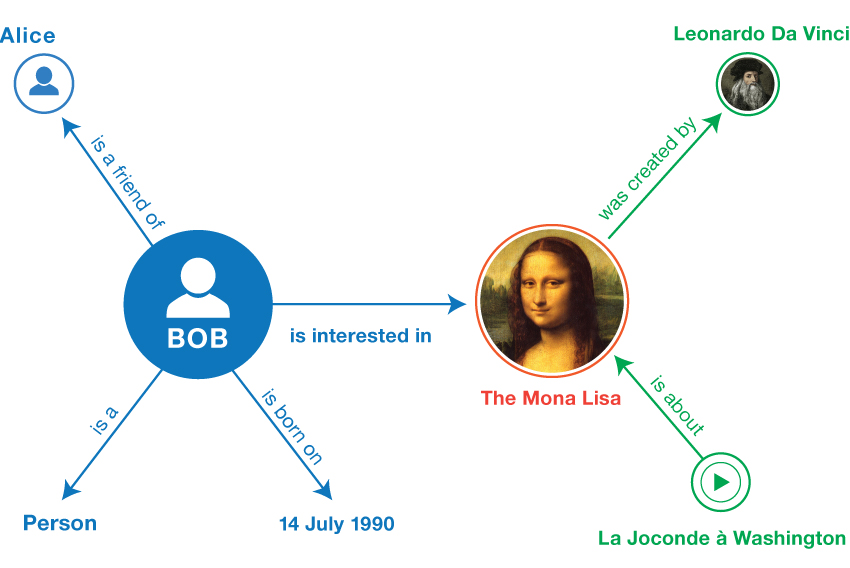
W3C의 RDF 입문서 예제. 노드는 대상이나 값, 화살표는 관계를 나타낸다. (출처: W3C RDF 1.1 Primer)
실무에서는 다음 네 역할을 분리해 생각하면 쉽습니다.
| 층 | 역할 | 이 글의 결과물 |
|---|---|---|
| RDF/Turtle | 데이터를 그래프로 표현·교환 | data.ttl |
| RDFS/OWL | 개념과 관계의 의미 정의 | ontology.ttl |
| SHACL | 들어온 데이터가 업무 규칙을 만족하는지 검사 | shapes.ttl |
| SPARQL | 그래프에서 필요한 답을 조회 | queries/services.sparql |
여기서 중요한 차이가 있습니다. OWL은 보통 열린 세계 가정을 따르므로 기록에 담당 팀이 없다고 곧바로 “담당 팀이 없다”라고 단정하지 않습니다. “모든 서비스에는 담당 팀이 정확히 하나 있어야 한다”는 입력 품질 요구는 SHACL의 sh:minCount·sh:maxCount로 검사합니다. OWL의 rdfs:domain·rdfs:range도 검증 오류 메시지라기보다 추론에 쓰이는 의미 선언입니다. 이 구분을 놓치면 모델은 그럴듯한데 불완전한 데이터가 계속 유입됩니다. (W3C OWL 2 Primer, W3C SHACL)
1단계: 질문과 범위를 먼저 고정한다
첫 회의에서 클래스 이름을 만들기보다 역량 질문(competency questions) 세 개를 적습니다.
- 계정 관련 서비스를 모두 찾을 수 있는가?
- 각 서비스의 책임 팀을 알 수 있는가?
- 책임 팀이 없는 서비스가 반입될 때 발견할 수 있는가?
질문마다 필요한 데이터 출처와 책임자를 붙입니다. 예를 들어 서비스 목록은 CMS, 팀 목록은 조직 시스템, 주제 목록은 지원팀의 관리 어휘에서 올 수 있습니다. 처음에는 수십 개 클래스보다 Service, Team, Topic 세 개와 실제 샘플 10~20건이 낫습니다. 프로젝트 범위 밖의 개념은 만들지 말고, 같은 말을 다른 팀이 다르게 쓰는 경우 정의와 예외를 기록합니다.
2단계: 저장소와 식별자 규칙을 만든다
프로젝트를 다음처럼 나누면 모델, 실제 데이터, 품질 규칙, 질의를 각각 검토할 수 있습니다.
ontology-project/
├── ontology.ttl           # 개념과 관계
├── shapes.ttl             # 반입 데이터의 품질 규칙
├── data.ttl               # 작은 테스트 데이터
├── mappings/              # DB·CSV·API → RDF 변환 규칙
├── queries/
│   └── services.sparql    # 역량 질문을 검증하는 질의
└── docs/                  # 용어 정의·소유자·변경 기록
클래스·속성의 IRI(…/ontology/Service)와 개별 레코드의 IRI(…/id/help-center)를 구분하세요. 화면에 보이는 이름이 바뀌어도 식별자는 가능한 유지하고, IRI를 재사용해 전혀 다른 대상을 가리키지 않도록 합니다. 이 예시의 주소는 발행된 실제 온톨로지가 아닙니다. 운영에서는 조직 소유의 안정적인 HTTPS 주소와 접근 가능한 문서를 준비합니다. (W3C RDF Concepts — IRI와 변경)
3단계: 작은 모델과 실제 데이터를 작성한다
아래는 ontology.ttl의 최소 모델입니다. ownedBy와 addressesTopic은 리터럴 값이 아니라 다른 개체를 가리키는 관계입니다.
@prefix ex: <https://example.org/ontology/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Service a owl:Class .
ex:Team a owl:Class .
ex:Topic a owl:Class .

ex:ownedBy a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Team .
ex:addressesTopic a owl:ObjectProperty ;
rdfs:domain ex:Service ; rdfs:range ex:Topic .data.ttl에는 테스트용 인스턴스를 넣습니다. rdfs:label은 사람이 읽을 이름이며, @ko는 언어 태그입니다.
@prefix ex: <https://example.org/ontology/> .
@prefix id: <https://example.org/id/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

id:help-center a ex:Service ;
  rdfs:label "도움말 센터"@ko ;
  ex:ownedBy id:cx-team ;
  ex:addressesTopic id:account .
id:cx-team a ex:Team ; rdfs:label "고객경험팀"@ko .
id:account a ex:Topic ; rdfs:label "계정"@ko .
Protégé Desktop는 OWL 모델의 클래스·속성을 시각적으로 편집하는 도구입니다. 팀 단위 협업에는 WebProtégé도 선택할 수 있습니다. 두 도구 모두 모델 편집용이고, 운영 데이터 저장소·반입 검증·서비스 API의 전부를 대신하지는 않습니다.
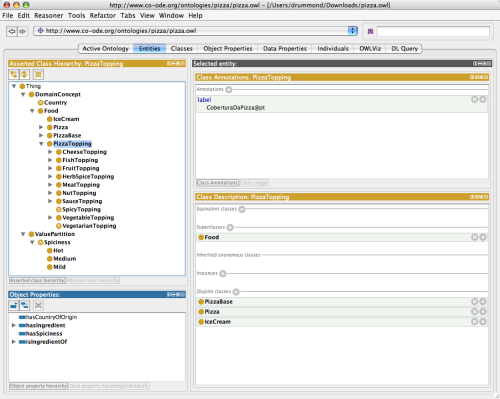
Stanford Protégé 공식 위키의 이전 버전 편집 화면. 클래스 계층과 속성 편집 영역이 분리되는 방식을 보여 주며, 현재 UI는 다를 수 있다. (출처: Protégé Getting Started)
4단계: SHACL로 반입 조건을 검증한다
shapes.ttl에는 서비스마다 한국어 또는 다른 언어의 이름 리터럴이 하나 이상 있고, 담당 팀은 정확히 하나이며 Team 유형이어야 한다는 규칙을 둡니다. 아래 예제는 이름의 존재와 리터럴 여부만 검사합니다. 특정 언어 태그까지 강제하려면 규칙을 추가해야 합니다.
@prefix ex: <https://example.org/ontology/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:ServiceShape a sh:NodeShape ;
  sh:targetClass ex:Service ;
  sh:property [ sh:path rdfs:label ;
                sh:minCount 1 ; sh:nodeKind sh:Literal ] ;
  sh:property [ sh:path ex:ownedBy ;
                sh:minCount 1 ; sh:maxCount 1 ;
                sh:class ex:Team ] .
Apache Jena 명령 도구를 설치한 뒤 프로젝트 폴더에서 다음을 실행합니다. Jena 버전에 맞는 Java 요구사항은 다운로드 페이지에서 확인하세요. data.ttl에서 ex:ownedBy 행을 지우고 다시 실행하면 누락 오류를 확인할 수 있습니다. 실제 반입 파이프라인에서는 이 검사를 통과한 데이터만 저장소로 보내야 합니다. (Jena SHACL 명령 문서)
shacl validate --shapes shapes.ttl --data data.ttl5단계: Fuseki에 싣고 질문을 질의로 바꾼다
Apache Jena Fuseki는 RDF를 적재하고 SPARQL로 조회할 수 있는 서버입니다. 공식 빠른 시작 안내처럼 서버를 실행해 http://localhost:3030/에서 catalog라는 인메모리 데이터셋을 만들고 ontology.ttl과 data.ttl을 추가합니다. 인메모리는 학습용이므로 운영 저장에는 지속형 저장소와 백업이 필요합니다. 쿼리 화면에서 다음 queries/services.sparql을 실행합니다.
PREFIX ex: <https://example.org/ontology/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?serviceName ?teamName WHERE {
  ?service a ex:Service ;
           rdfs:label ?serviceName ;
           ex:ownedBy ?team .
  ?team rdfs:label ?teamName .
  FILTER(LANG(?serviceName) = "ko" && LANG(?teamName) = "ko")
}
예상 결과는 도움말 센터 — 고객경험팀 한 행입니다. ex:addressesTopic과 Topic의 이름을 추가하면 첫 번째 역량 질문도 조회할 수 있습니다. 이 단계에서 중요한 것은 그래프가 예쁜지가 아니라, 처음 적은 업무 질문에 질의 결과가 정확히 답하는지입니다. (W3C SPARQL 1.1 Query, Fuseki Quickstart)
실제 운영 구조: 파일이 아니라 파이프라인으로 본다
원천 시스템(DB·CSV·API)
  → 매핑/정규화 → RDF 데이터
  → SHACL 검증 → 트리플 저장소(Fuseki 등)
  → SPARQL/API → 검색·분석·서비스 화면
       ↑
  버전 관리되는 온톨로지·용어 정의·테스트 질의
운영 단계에서는 세 가지를 별도로 설계해야 합니다. 변경 관리는 용어의 소유자, 클래스·속성의 변경 승인, 이전 IRI와의 호환성을 정합니다. 데이터 계보는 각 트리플의 원천과 갱신 시각을 추적합니다. 배포 관리는 테스트 데이터 검증, 역량 질문 회귀 테스트, 접근 권한, 백업·복원 절차를 포함합니다. 추론기가 필요한 경우에만 별도 단계로 추가하고, 추론 결과와 원본 사실을 구별해 저장·제공하세요. RDF의 명명 그래프는 출처별 데이터를 구분하는 한 가지 수단이지만, 그 자체가 권한 관리나 계보 정책을 자동으로 완성해 주지는 않습니다. (W3C RDF Datasets)
처음부터 대규모 지식 그래프를 목표로 할 필요는 없습니다. 세 개의 업무 질문, 세 개의 핵심 클래스, 소량의 실제 샘플, 한 번의 검증과 한 개의 질의가 동작하면 이미 실용적인 출발점입니다. 그 후 새 데이터 출처와 질문이 생길 때 모델을 넓히는 편이 검증 가능하고 유지보수하기 쉽습니다.
An ontology is not a technique for drawing everything in the world as one giant graph. It is a semantic model: an agreement about which concepts matter in a particular domain, how they relate, and what those relations mean to a system. Done well, it lets data from different teams answer the same question consistently. Without a question and clear ownership, it becomes a dictionary nobody maintains.
We will follow a fictional service-catalog project from start to finish. Its guiding question is: “Which service addresses which topic, and which team owns it?” The https://example.org/ identifiers below are illustrative; replace them with a domain your organization controls in a real project.
First, distinguish a taxonomy, a database schema, and an ontology
| Tool | Main question | Example |
|---|---|---|
| Taxonomy | What is a narrower kind of what? | Support topics → Accounts → Login |
| Database schema | What is stored, and in which format? | services.owner_team_id |
| Ontology | What do concepts and relations mean? | A service is owned by a team and addresses a topic |
An ontology does not replace a database. It is closer to a shared semantic contract for connecting data already held in databases, CSV files, and APIs. If you only need a navigation hierarchy, a taxonomy or SKOS may be enough. Ontology work pays off when entities and relations from several sources must be reused, reasoned over, or queried together.
The core building blocks at a glance
RDF represents information as subject–predicate–object triples: for example, Help Center → owned by → Customer Experience Team. An IRI identifies a resource; a literal can hold a value such as a name or date. OWL 2 adds definitions of classes, properties, and logical relationships that support reasoning.
An example from the W3C RDF Primer. Nodes represent resources or values; arrows represent relations. (Source: W3C RDF 1.1 Primer)
In practice, it helps to separate four jobs:
| Layer | Job | File in this project |
|---|---|---|
| RDF/Turtle | Represent and exchange graph data | data.ttl |
| RDFS/OWL | Define concepts and the meaning of relations | ontology.ttl |
| SHACL | Check incoming data against business rules | shapes.ttl |
| SPARQL | Retrieve answers from the graph | queries/services.sparql |
There is an important distinction here. OWL generally follows an open-world assumption: if a record lacks an owner, that does not automatically mean no owner exists. The input-quality rule “every service must have exactly one owner” belongs in SHACL, using sh:minCount and sh:maxCount. OWL's rdfs:domain and rdfs:range are semantic declarations used for inference, not validation error messages. Confusing the two can leave you with an elegant model and incomplete data. (W3C OWL 2 Primer, W3C SHACL)
Step 1: Fix the questions and scope first
Rather than naming classes in the first meeting, write three competency questions:
- Can we find every service related to accounts?
- Can we identify the team responsible for each service?
- Can we detect an incoming service with no responsible team?
Assign a source and an owner to each question. Services might come from a CMS, teams from an organization system, and topics from a support team's managed vocabulary. Start with Service, Team, and Topic, plus 10–20 real sample records, rather than dozens of speculative classes. Do not model concepts outside the project scope; document definitions and exceptions when teams use the same word differently.
Step 2: Set up the repository and identifier rules
Separating model, data, quality rules, and queries makes each independently reviewable.
ontology-project/
├── ontology.ttl           # 개념과 관계
├── shapes.ttl             # 반입 데이터의 품질 규칙
├── data.ttl               # 작은 테스트 데이터
├── mappings/              # DB·CSV·API → RDF 변환 규칙
├── queries/
│   └── services.sparql    # 역량 질문을 검증하는 질의
└── docs/                  # 용어 정의·소유자·변경 기록
Keep the IRI for a class or property (…/ontology/Service) distinct from an individual record (…/id/help-center). Try to keep identifiers stable even when display names change, and never reuse an IRI for a completely different thing. The example addresses here do not point to a published ontology. In production, use stable HTTPS addresses under a domain your organization owns and provide accessible documentation. (W3C RDF Concepts — IRIs and change)
Step 3: Write a small model and real data
Here is a minimal ontology.ttl. ownedBy and addressesTopic point to other entities rather than literal values.
@prefix ex: <https://example.org/ontology/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Service a owl:Class .
ex:Team a owl:Class .
ex:Topic a owl:Class .

ex:ownedBy a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Team .
ex:addressesTopic a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Topic .
Put test instances in data.ttl. rdfs:label is a human-readable name, and @ko is its language tag.
@prefix ex: <https://example.org/ontology/> .
@prefix id: <https://example.org/id/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

id:help-center a ex:Service ;
  rdfs:label "도움말 센터"@ko ;
  ex:ownedBy id:cx-team ;
  ex:addressesTopic id:account .
id:cx-team a ex:Team ; rdfs:label "고객경험팀"@ko .
id:account a ex:Topic ; rdfs:label "계정"@ko .
Protégé Desktop is a visual editor for OWL classes and properties. WebProtégé is an option for collaborative editing. Neither tool replaces every part of the runtime data store, ingestion validation, or application API.
An older editor interface from the official Stanford Protégé wiki. It illustrates separate areas for class hierarchy and property editing; the current UI may differ. (Source: Protégé Getting Started)
Step 4: Validate incoming data with SHACL
In shapes.ttl, require at least one name literal and exactly one owner of type Team for each service. This example checks the name's presence and literal kind, not a particular language tag. Add another rule if a language is mandatory.
@prefix ex: <https://example.org/ontology/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:ServiceShape a sh:NodeShape ;
  sh:targetClass ex:Service ;
  sh:property [ sh:path rdfs:label ;
                sh:minCount 1 ; sh:nodeKind sh:Literal ] ;
  sh:property [ sh:path ex:ownedBy ;
                sh:minCount 1 ; sh:maxCount 1 ;
                sh:class ex:Team ] .
After installing the Apache Jena command-line tools, run the following in the project directory. Check the download page for the Java requirements of your Jena version. Remove the ex:ownedBy line from data.ttl and rerun it to see a missing-value violation. A production ingestion pipeline should send only validated data to the store. (Jena SHACL command documentation)
shacl validate --shapes shapes.ttl --data data.ttl
Step 5: Load Fuseki and turn the question into a query
Apache Jena Fuseki is a server for loading RDF and querying it with SPARQL. Following the official quickstart, start the server, open http://localhost:3030/, create an in-memory dataset named catalog, and add ontology.ttl and data.ttl. In-memory storage is for learning; production needs persistent storage and backups. Run this queries/services.sparql in the query interface:
PREFIX ex: <https://example.org/ontology/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?serviceName ?teamName WHERE {
  ?service a ex:Service ;
           rdfs:label ?serviceName ;
           ex:ownedBy ?team .
  ?team rdfs:label ?teamName .
  FILTER(LANG(?serviceName) = "ko" && LANG(?teamName) = "ko")
}
The expected result is one row: 도움말 센터 — 고객경험팀. Add ex:addressesTopic and the Topic label to answer the first competency question as well. The test is not whether the graph looks impressive; it is whether the query correctly answers the business question you started with. (W3C SPARQL 1.1 Query, Fuseki Quickstart)
Operating architecture: think pipeline, not just files
원천 시스템(DB·CSV·API)
  → 매핑/정규화 → RDF 데이터
  → SHACL 검증 → 트리플 저장소(Fuseki 등)
  → SPARQL/API → 검색·분석·서비스 화면
       ↑
  버전 관리되는 온톨로지·용어 정의·테스트 질의
Three operational concerns need separate designs. Change management defines term owners, approval of class/property changes, and compatibility with old IRIs. Data lineage tracks where triples came from and when they changed. Release management includes sample-data validation, regression tests for competency questions, access controls, and backup/restore procedures. Add a reasoner only when the use case needs one, and distinguish inferred results from asserted facts when storing or exposing them. RDF named graphs can help separate data by source, but they do not automatically implement access control or a lineage policy. (W3C RDF Datasets)
There is no need to aim for a vast knowledge graph on day one. Three business questions, three core classes, a small real sample, one validation run, and one working query are already a useful starting point. Expand the model as new sources and questions arrive; the result will be easier to test and maintain.
本体并不是“把世界上的一切画成巨型图谱”的技术。它是一种语义模型:针对特定业务,约定哪些概念重要、概念之间如何关联,以及系统应怎样理解这些关系。设计得当时,不同团队的数据可以一致地回答同一个问题;缺少问题和维护责任时,它只会变成无人更新的词典。
本文以虚构的服务目录项目贯穿全过程。核心问题是:“哪项服务处理什么主题,由哪个团队负责?”下文的 https://example.org/ 仅用于示例;实际项目应替换为组织自己控制的域名。
先分清分类体系、数据库模式与本体
| 工具 | 主要回答的问题 | 示例 |
|---|---|---|
| 分类体系 | 什么是谁的下级类别? | 支持主题 → 账户 → 登录 |
| 数据库模式 | 以什么格式存储什么? | services.owner_team_id |
| 本体 | 概念及关系的含义是什么? | 服务由团队负责,并处理某个主题 |
本体不会替代数据库。它更像一份共享的语义契约,用来连接已有数据库、CSV 和 API 中的数据。如果只需要导航层级,分类体系或 SKOS 可能已经足够。当多个来源的实体和关系需要统一复用、推理或查询时,本体的投入才更有价值。
一图理解核心构件
RDF 用主语–谓语–宾语三元组表示信息,例如 帮助中心 → 负责团队 → 客户体验团队。IRI 标识资源,字面量可保存名称、日期等值。OWL 2 在此基础上定义类、属性和逻辑关系,并支持推理。
W3C RDF 入门文档中的示例:节点表示资源或值,箭头表示关系。(来源:W3C RDF 1.1 Primer)
实践中可将四项工作分开:
| 层 | 职责 | 本文文件 |
|---|---|---|
| RDF/Turtle | 表达和交换图数据 | data.ttl |
| RDFS/OWL | 定义概念与关系语义 | ontology.ttl |
| SHACL | 按业务规则检查导入数据 | shapes.ttl |
| SPARQL | 从图中查询答案 | queries/services.sparql |
这里有一个关键区别。OWL 通常采用开放世界假设:记录中没有负责人,并不等于负责人不存在。“每项服务必须且只能有一个负责人”这样的输入质量要求,应通过 SHACL 的 sh:minCount 和 sh:maxCount 检查。OWL 的 rdfs:domain、rdfs:range 是用于推理的语义声明,而非校验报错规则。混淆两者,会得到漂亮的模型,却持续导入不完整的数据。(W3C OWL 2 Primer、W3C SHACL)
第一步:先确定问题与范围
第一次会议不要急于给类命名,先写下三个能力问题(competency questions):
- 能否找到所有与账户相关的服务?
- 能否知道每项服务的负责团队?
- 导入没有负责团队的服务时,能否发现问题?
为每个问题标明数据来源和负责人。服务可来自 CMS,团队来自组织系统,主题来自支持团队维护的受控词表。起步时,与其设想几十个类,不如先用 Service、Team、Topic 和 10–20 条真实样例。范围外的概念暂不建模;不同团队对同一术语有不同理解时,记录定义及例外。
第二步:建立仓库和标识符规则
将模型、数据、质量规则和查询分开,才能分别审查。
ontology-project/
├── ontology.ttl           # 개념과 관계
├── shapes.ttl             # 반입 데이터의 품질 규칙
├── data.ttl               # 작은 테스트 데이터
├── mappings/              # DB·CSV·API → RDF 변환 규칙
├── queries/
│   └── services.sparql    # 역량 질문을 검증하는 질의
└── docs/                  # 용어 정의·소유자·변경 기록
类或属性的 IRI(…/ontology/Service)与具体记录的 IRI(…/id/help-center)应区分。显示名称变化时尽量保持标识符不变,也不要让同一 IRI 后来指向完全不同的事物。这里的示例地址并非已发布的本体;生产环境应使用组织自有域名下稳定的 HTTPS 地址,并提供可访问的文档。(W3C RDF Concepts:IRI 与变更)
第三步:编写小型模型和真实数据
下面是最小化的 ontology.ttl。ownedBy 和 addressesTopic 指向其他实体,而不是文本值。
@prefix ex: <https://example.org/ontology/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Service a owl:Class .
ex:Team a owl:Class .
ex:Topic a owl:Class .

ex:ownedBy a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Team .
ex:addressesTopic a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Topic .
在 data.ttl 中放入测试实例。rdfs:label 是供人阅读的名称,@ko 是语言标签。
@prefix ex: <https://example.org/ontology/> .
@prefix id: <https://example.org/id/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

id:help-center a ex:Service ;
  rdfs:label "도움말 센터"@ko ;
  ex:ownedBy id:cx-team ;
  ex:addressesTopic id:account .
id:cx-team a ex:Team ; rdfs:label "고객경험팀"@ko .
id:account a ex:Topic ; rdfs:label "계정"@ko .
Protégé Desktop 可视化编辑 OWL 类和属性;团队协作也可选 WebProtégé。它们是模型编辑工具,不会包办运行时数据存储、导入校验或应用 API。
Stanford Protégé 官方 Wiki 的旧版编辑界面,展示类层级与属性编辑区的分离方式;当前界面可能不同。(来源:Protégé Getting Started)
第四步:用 SHACL 校验导入数据
在 shapes.ttl 中规定:每项服务至少有一个名称字面量,且恰有一个类型为 Team 的负责团队。此例只检查名称的存在性和字面量类型,不强制特定语言标签;若语言有要求,还需增加规则。
@prefix ex: <https://example.org/ontology/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:ServiceShape a sh:NodeShape ;
  sh:targetClass ex:Service ;
  sh:property [ sh:path rdfs:label ;
                sh:minCount 1 ; sh:nodeKind sh:Literal ] ;
  sh:property [ sh:path ex:ownedBy ;
                sh:minCount 1 ; sh:maxCount 1 ;
                sh:class ex:Team ] .
安装 Apache Jena 命令行工具 后,在项目目录运行以下命令。请在下载页核对所用 Jena 版本的 Java 要求。删除 data.ttl 中的 ex:ownedBy 一行并重新运行,即可看到缺失值违规。生产导入流水线应只将通过校验的数据送入存储库。(Jena SHACL 命令文档)
shacl validate --shapes shapes.ttl --data data.ttl
第五步:导入 Fuseki,并把问题变成查询
Apache Jena Fuseki 是加载 RDF 并提供 SPARQL 查询的服务器。按官方快速入门启动服务,在 http://localhost:3030/ 创建名为 catalog 的内存数据集,然后加入 ontology.ttl 和 data.ttl。内存数据集适合学习;生产环境还需要持久化存储和备份。在查询界面运行以下 queries/services.sparql:
PREFIX ex: <https://example.org/ontology/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?serviceName ?teamName WHERE {
  ?service a ex:Service ;
           rdfs:label ?serviceName ;
           ex:ownedBy ?team .
  ?team rdfs:label ?teamName .
  FILTER(LANG(?serviceName) = "ko" && LANG(?teamName) = "ko")
}
预期结果是一行:도움말 센터 — 고객경험팀。加入 ex:addressesTopic 和 Topic 的名称,还能回答第一个能力问题。关键并非图谱看上去有多复杂,而是查询能否正确回答最初的业务问题。(W3C SPARQL 1.1 Query、Fuseki Quickstart)
运行架构:把它看作流水线,而非一组文件
원천 시스템(DB·CSV·API)
  → 매핑/정규화 → RDF 데이터
  → SHACL 검증 → 트리플 저장소(Fuseki 등)
  → SPARQL/API → 검색·분석·서비스 화면
       ↑
  버전 관리되는 온톨로지·용어 정의·테스트 질의
上线后需分别设计三件事。变更管理确定术语负责人、类与属性变更的审批,以及旧 IRI 的兼容性。数据血缘追踪每条三元组的来源和更新时间。发布管理涵盖样例数据校验、能力问题的回归测试、访问权限以及备份恢复。只有用例确实需要时才加入推理器,并在存储或提供结果时区分推断结论与原始事实。RDF 命名图可以帮助按来源分隔数据,但不会自动完成权限控制或血缘策略。(W3C RDF Datasets)
第一天不必追求庞大的知识图谱。三个业务问题、三个核心类、少量真实样例、一次校验和一个可运行的查询,已经是实用的起点。随着新来源和新问题出现再扩展模型,才更容易测试和维护。
オントロジーは「世界のすべてを巨大なグラフに描く技術」ではありません。特定の業務で何を概念とみなし、概念間の関係をどう定義し、システムがそれをどう解釈するかを共有する意味モデルです。適切に設計すれば、異なるチームのデータが同じ問いに一貫して答えられます。目的と管理責任がなければ、更新されない用語集になってしまいます。
この記事では架空のサービスカタログを最初から最後まで作ります。中心となる問いは「どのサービスが何のトピックを扱い、どのチームが担当するか」です。以下の https://example.org/ は説明用であり、実案件では組織が管理するドメインに置き換えてください。
まず分類体系、データベーススキーマ、オントロジーを区別する
| 道具 | 主に答える問い | 例 |
|---|---|---|
| 分類体系 | 何が何の下位項目か? | サポート項目 → アカウント → ログイン |
| DBスキーマ | 何をどの形式で保存するか? | services.owner_team_id |
| オントロジー | 概念と関係は何を意味するか? | サービスはチームが担当し、トピックを扱う |
オントロジーはデータベースの代替ではありません。既存のDB、CSV、APIのデータを共通の意味でつなぐ契約に近いものです。単なるナビゲーション階層なら、分類体系や SKOS で十分な場合もあります。複数の情報源の実体と関係を再利用・推論・横断検索する場合に、その構築コストが意味を持ちます。
主要な構成要素を把握する
RDF は情報を主語–述語–目的語のトリプルで表します。たとえば ヘルプセンター → 担当チーム → カスタマーエクスペリエンスチーム です。IRIは対象の識別子で、名前や日付などはリテラル値として表せます。OWL 2 はその上でクラス、プロパティ、論理関係を定義し、推論を可能にします。
W3CのRDF入門書にある例。ノードは対象や値、矢印は関係を表す。(出典:W3C RDF 1.1 Primer)
実務では四つの役割を分けると理解しやすくなります。
| 層 | 役割 | この例のファイル |
|---|---|---|
| RDF/Turtle | グラフデータの表現・交換 | data.ttl |
| RDFS/OWL | 概念と関係の意味の定義 | ontology.ttl |
| SHACL | 取り込むデータの業務規則による検査 | shapes.ttl |
| SPARQL | グラフからの回答の取得 | queries/services.sparql |
ここには重要な違いがあります。OWLは通常オープンワールド仮定に従うため、担当者の記録がないことは「担当者が存在しない」ことを意味しません。「各サービスの担当チームは必ず一つ」という入力品質の要件は、SHACL の sh:minCount と sh:maxCount で検査します。OWLの rdfs:domain と rdfs:range は検証エラーではなく、推論に使う意味の宣言です。両者を混同すると、モデルは整っていても不完全なデータが入り続けます。(W3C OWL 2 Primer、W3C SHACL)
ステップ1:問いと対象範囲を先に決める
最初の会議ではクラス名より、三つのコンピテンシークエスチョンを記します。
- アカウントに関係するサービスをすべて見つけられるか?
- 各サービスの担当チームが分かるか?
- 担当チームがないサービスの取り込みを検知できるか?
問いごとにデータの出所と責任者を紐づけます。サービスはCMS、チームは組織管理システム、トピックはサポートチームの管理語彙から来るかもしれません。最初は推測で数十のクラスを作るより、Service、Team、Topic と実データ10~20件で始めます。範囲外の概念は作らず、チーム間で同じ言葉の意味が違うときは定義と例外を記録します。
ステップ2:リポジトリと識別子の規則を作る
モデル、データ、品質規則、クエリを分離すると、それぞれをレビューできます。
ontology-project/
├── ontology.ttl           # 개념과 관계
├── shapes.ttl             # 반입 데이터의 품질 규칙
├── data.ttl               # 작은 테스트 데이터
├── mappings/              # DB·CSV·API → RDF 변환 규칙
├── queries/
│   └── services.sparql    # 역량 질문을 검증하는 질의
└── docs/                  # 용어 정의·소유자·변경 기록
クラスやプロパティのIRI(…/ontology/Service)と個々のレコードのIRI(…/id/help-center)は分けます。表示名が変わっても識別子はできるだけ維持し、同じIRIをまったく別の対象に再利用しないでください。この例のURLは公開済みオントロジーではありません。運用時は組織が所有する安定したHTTPSアドレスと参照できる文書を用意します。(W3C RDF Concepts:IRIと変更)
ステップ3:小さなモデルと実データを書く
次が最小限の ontology.ttl です。ownedBy と addressesTopic は文字列ではなく、別の実体を指す関係です。
@prefix ex: <https://example.org/ontology/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Service a owl:Class .
ex:Team a owl:Class .
ex:Topic a owl:Class .

ex:ownedBy a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Team .
ex:addressesTopic a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Topic .
テスト用インスタンスは data.ttl に入れます。rdfs:label は人が読む名前、@ko は言語タグです。
@prefix ex: <https://example.org/ontology/> .
@prefix id: <https://example.org/id/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

id:help-center a ex:Service ;
  rdfs:label "도움말 센터"@ko ;
  ex:ownedBy id:cx-team ;
  ex:addressesTopic id:account .
id:cx-team a ex:Team ; rdfs:label "고객경험팀"@ko .
id:account a ex:Topic ; rdfs:label "계정"@ko .
Protégé Desktop はOWLのクラスとプロパティを視覚的に編集するツールです。共同編集には WebProtégé も選べます。ただし、これらは運用データの保存、取り込み検証、サービスAPIのすべてを代替するものではありません。
Stanford Protégé公式Wikiの旧版画面。クラス階層とプロパティ編集領域の分離を示しており、現在のUIとは異なる場合がある。(出典:Protégé Getting Started)
ステップ4:SHACLで取り込み条件を検査する
shapes.ttl では、各サービスに名前のリテラルが一つ以上あり、担当チームがちょうど一つで型が Team であることを要求します。次の例は名前の存在とリテラルであることだけを検査し、言語タグまでは指定しません。特定言語が必須なら規則を追加します。
@prefix ex: <https://example.org/ontology/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:ServiceShape a sh:NodeShape ;
  sh:targetClass ex:Service ;
  sh:property [ sh:path rdfs:label ;
                sh:minCount 1 ; sh:nodeKind sh:Literal ] ;
  sh:property [ sh:path ex:ownedBy ;
                sh:minCount 1 ; sh:maxCount 1 ;
                sh:class ex:Team ] .
Apache Jenaのコマンドラインツールをインストールし、プロジェクト内で次を実行します。使用するJena版のJava要件はダウンロードページで確認してください。data.ttl の ex:ownedBy 行を削除して再実行すれば、値の欠落を検出できます。運用の取り込みパイプラインでは、検証に通ったデータだけをストアへ送ります。(Jena SHACLコマンド文書)
shacl validate --shapes shapes.ttl --data data.ttl
ステップ5:Fusekiへ読み込み、問いをクエリにする
Apache Jena Fuseki はRDFを読み込み、SPARQLで検索するサーバーです。公式クイックスタートに従って起動し、http://localhost:3030/ で catalog というインメモリデータセットを作り、ontology.ttl と data.ttl を追加します。インメモリ方式は学習用で、運用には永続ストレージとバックアップが必要です。クエリ画面で次の queries/services.sparql を実行します。
PREFIX ex: <https://example.org/ontology/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?serviceName ?teamName WHERE {
  ?service a ex:Service ;
           rdfs:label ?serviceName ;
           ex:ownedBy ?team .
  ?team rdfs:label ?teamName .
  FILTER(LANG(?serviceName) = "ko" && LANG(?teamName) = "ko")
}
期待する結果は 도움말 센터 — 고객경험팀 の一行です。ex:addressesTopic と Topic の名前を加えれば、最初の問いにも答えられます。重要なのはグラフの見栄えではなく、最初に定めた業務上の問いへクエリが正確に答えることです。(W3C SPARQL 1.1 Query、Fuseki Quickstart)
運用構成:ファイル群ではなくパイプラインとして考える
원천 시스템(DB·CSV·API)
  → 매핑/정규화 → RDF 데이터
  → SHACL 검증 → 트리플 저장소(Fuseki 등)
  → SPARQL/API → 검색·분석·서비스 화면
       ↑
  버전 관리되는 온톨로지·용어 정의·테스트 질의
運用では三つの課題を別々に設計します。変更管理は用語の責任者、クラス・プロパティ変更の承認、古いIRIとの互換性を定めます。データリネージは各トリプルの出所と更新時刻を追跡します。リリース管理にはサンプルデータの検証、問いに対する回帰テスト、アクセス権、バックアップと復元が含まれます。推論器は必要な場合だけ追加し、推論結果と元の事実を区別して保存・提供します。RDFの名前付きグラフは出所別の分離に使えますが、それだけで権限管理やリネージ方針が完成するわけではありません。(W3C RDF Datasets)
初日から巨大な知識グラフを目指す必要はありません。三つの業務質問、三つの主要クラス、少量の実例、一回の検証、一つの動くクエリがあれば、実用的な第一歩です。新たなデータ源や問いが現れたときにモデルを拡張するほうが、検証と保守を続けやすくなります。
Una ontología no es una técnica para dibujar todo el mundo como un grafo gigantesco. Es un modelo semántico: un acuerdo sobre qué conceptos importan en un ámbito, cómo se relacionan y qué significan esas relaciones para el sistema. Bien diseñada, permite que los datos de distintos equipos respondan de forma coherente a una misma pregunta. Sin preguntas ni responsables, acaba siendo un diccionario que nadie mantiene.
Seguiremos de principio a fin un proyecto ficticio de catálogo de servicios. Su pregunta central es: «¿Qué servicio trata cada tema y qué equipo se encarga de él?». Los identificadores https://example.org/ son ilustrativos; en un proyecto real deben sustituirse por un dominio controlado por la organización.
Distinguir taxonomía, esquema de base de datos y ontología
| Herramienta | Pregunta principal | Ejemplo |
|---|---|---|
| Taxonomía | ¿Qué es una subcategoría de qué? | Temas de ayuda → Cuentas → Inicio de sesión |
| Esquema de base de datos | ¿Qué se guarda y en qué formato? | services.owner_team_id |
| Ontología | ¿Qué significan los conceptos y sus relaciones? | Un equipo se responsabiliza de un servicio que trata un tema |
La ontología no sustituye a la base de datos. Se parece más a un contrato semántico compartido para conectar datos existentes en bases de datos, CSV y API. Si solo hace falta una jerarquía de navegación, una taxonomía o SKOS pueden bastar. El esfuerzo de crear una ontología se justifica cuando entidades y relaciones de varias fuentes deben reutilizarse, inferirse o consultarse conjuntamente.
Los componentes esenciales de un vistazo
RDF representa la información mediante ternas sujeto–predicado–objeto; por ejemplo, Centro de ayuda → equipo responsable → Equipo de experiencia del cliente. Un IRI identifica un recurso, mientras que un literal puede contener un nombre o una fecha. OWL 2 añade definiciones de clases, propiedades y relaciones lógicas que permiten el razonamiento.
Ejemplo del manual introductorio de RDF del W3C. Los nodos representan recursos o valores; las flechas, relaciones. (Fuente: W3C RDF 1.1 Primer)
En la práctica conviene separar cuatro funciones:
| Capa | Función | Archivo de este proyecto |
|---|---|---|
| RDF/Turtle | Representar e intercambiar datos de grafo | data.ttl |
| RDFS/OWL | Definir conceptos y el significado de las relaciones | ontology.ttl |
| SHACL | Comprobar reglas de negocio en los datos entrantes | shapes.ttl |
| SPARQL | Obtener respuestas del grafo | queries/services.sparql |
Hay una distinción fundamental. OWL suele seguir la suposición de mundo abierto: que un registro no tenga responsable no significa automáticamente que este no exista. La regla de calidad «cada servicio debe tener exactamente un equipo responsable» se comprueba con sh:minCount y sh:maxCount de SHACL. rdfs:domain y rdfs:range de OWL son declaraciones semánticas usadas para inferir, no mensajes de error de validación. Confundir ambos propósitos puede dejar un modelo elegante lleno de datos incompletos. (W3C OWL 2 Primer, W3C SHACL)
Paso 1: definir preguntas y alcance
Antes de poner nombre a las clases en la primera reunión, escriba tres preguntas de competencia:
- ¿Podemos encontrar todos los servicios relacionados con cuentas?
- ¿Podemos identificar el equipo responsable de cada servicio?
- ¿Podemos detectar la entrada de un servicio sin equipo responsable?
Asigne una fuente y un responsable a cada pregunta. Los servicios pueden proceder de un CMS; los equipos, de un sistema organizativo; y los temas, de un vocabulario gestionado por soporte. Es mejor empezar con Service, Team y Topic y entre 10 y 20 registros reales que con decenas de clases hipotéticas. No modele conceptos fuera del alcance; documente definiciones y excepciones cuando distintos equipos usen la misma palabra con sentidos diferentes.
Paso 2: organizar el repositorio y los identificadores
Separar modelo, datos, reglas de calidad y consultas permite revisar cada parte de forma independiente.
ontology-project/
├── ontology.ttl           # 개념과 관계
├── shapes.ttl             # 반입 데이터의 품질 규칙
├── data.ttl               # 작은 테스트 데이터
├── mappings/              # DB·CSV·API → RDF 변환 규칙
├── queries/
│   └── services.sparql    # 역량 질문을 검증하는 질의
└── docs/                  # 용어 정의·소유자·변경 기록
Distinga los IRI de clases y propiedades (…/ontology/Service) de los de registros individuales (…/id/help-center). Procure mantener el identificador aunque cambie el nombre visible; nunca reutilice un IRI para una entidad totalmente distinta. Las direcciones del ejemplo no corresponden a una ontología publicada. En producción, use direcciones HTTPS estables bajo un dominio propio y proporcione documentación accesible. (W3C RDF Concepts: IRI y cambios)
Paso 3: escribir un modelo pequeño y datos reales
Este es un ontology.ttl mínimo. ownedBy y addressesTopic apuntan a otras entidades, no a valores de texto.
@prefix ex: <https://example.org/ontology/> .
@prefix owl: <http://www.w3.org/2002/07/owl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Service a owl:Class .
ex:Team a owl:Class .
ex:Topic a owl:Class .

ex:ownedBy a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Team .
ex:addressesTopic a owl:ObjectProperty ;
  rdfs:domain ex:Service ; rdfs:range ex:Topic .
Los individuos de prueba van en data.ttl. rdfs:label es un nombre legible por personas y @ko indica el idioma.
@prefix ex: <https://example.org/ontology/> .
@prefix id: <https://example.org/id/> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

id:help-center a ex:Service ;
  rdfs:label "도움말 센터"@ko ;
  ex:ownedBy id:cx-team ;
  ex:addressesTopic id:account .
id:cx-team a ex:Team ; rdfs:label "고객경험팀"@ko .
id:account a ex:Topic ; rdfs:label "계정"@ko .
Protégé Desktop permite editar visualmente clases y propiedades OWL. WebProtégé ofrece una opción de trabajo colaborativo. Ninguno sustituye por completo al almacén de datos operativo, la validación de entradas o la API de la aplicación.
Interfaz de una versión anterior publicada en la wiki oficial de Stanford Protégé. Muestra la separación entre jerarquía de clases y edición de propiedades; la interfaz actual puede ser distinta. (Fuente: Protégé Getting Started)
Paso 4: validar las entradas con SHACL
En shapes.ttl, exigimos al menos un literal de nombre y exactamente un responsable de tipo Team por servicio. El ejemplo comprueba la presencia y el tipo literal del nombre, no una etiqueta de idioma concreta. Añada otra regla si se exige un idioma determinado.
@prefix ex: <https://example.org/ontology/> .
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:ServiceShape a sh:NodeShape ;
  sh:targetClass ex:Service ;
  sh:property [ sh:path rdfs:label ;
                sh:minCount 1 ; sh:nodeKind sh:Literal ] ;
  sh:property [ sh:path ex:ownedBy ;
                sh:minCount 1 ; sh:maxCount 1 ;
                sh:class ex:Team ] .
Instale las herramientas de línea de comandos de Apache Jena y ejecute esto desde la carpeta del proyecto. Consulte en la página de descarga los requisitos de Java de su versión de Jena. Si elimina la línea ex:ownedBy de data.ttl y repite la prueba, verá un incumplimiento por valor ausente. En producción, el flujo de ingestión debería enviar al almacén solo datos válidos. (Documentación del comando SHACL de Jena)
shacl validate --shapes shapes.ttl --data data.ttl
Paso 5: cargar Fuseki y convertir la pregunta en consulta
Apache Jena Fuseki es un servidor para cargar RDF y consultarlo con SPARQL. Según la guía oficial, arranque el servidor, abra http://localhost:3030/, cree un conjunto en memoria llamado catalog y añada ontology.ttl y data.ttl. La memoria sirve para aprender; en producción hacen falta almacenamiento persistente y copias de seguridad. Ejecute este queries/services.sparql en la interfaz de consultas:
PREFIX ex: <https://example.org/ontology/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>

SELECT ?serviceName ?teamName WHERE {
  ?service a ex:Service ;
           rdfs:label ?serviceName ;
           ex:ownedBy ?team .
  ?team rdfs:label ?teamName .
  FILTER(LANG(?serviceName) = "ko" && LANG(?teamName) = "ko")
}
El resultado esperado es una fila: 도움말 센터 — 고객경험팀. Si añade ex:addressesTopic y la etiqueta de Topic, podrá responder también a la primera pregunta de competencia. Lo decisivo no es que el grafo parezca espectacular, sino que la consulta responda correctamente a la pregunta de negocio inicial. (W3C SPARQL 1.1 Query, Fuseki Quickstart)
Arquitectura operativa: pensar en un flujo, no solo en archivos
원천 시스템(DB·CSV·API)
  → 매핑/정규화 → RDF 데이터
  → SHACL 검증 → 트리플 저장소(Fuseki 등)
  → SPARQL/API → 검색·분석·서비스 화면
       ↑
  버전 관리되는 온톨로지·용어 정의·테스트 질의
La operación exige diseñar tres aspectos por separado. La gestión de cambios define responsables de términos, aprobación de cambios en clases y propiedades y compatibilidad con IRI antiguos. El linaje de datos rastrea la fuente y fecha de actualización de cada terna. La gestión de versiones incluye validar muestras, probar de nuevo las preguntas de competencia, controlar el acceso y preparar copias de seguridad y restauración. Añada un razonador solo si el caso lo requiere, y distinga resultados inferidos de hechos declarados al almacenarlos o exponerlos. Los grafos con nombre de RDF ayudan a separar datos por fuente, pero no implementan por sí solos el control de acceso ni una política de linaje. (W3C RDF Datasets)
No hace falta intentar construir un gran grafo de conocimiento desde el primer día. Tres preguntas de negocio, tres clases principales, unas pocas muestras reales, una validación y una consulta funcional ya constituyen un comienzo útil. Amplíe el modelo cuando aparezcan nuevas fuentes y preguntas: será más fácil comprobarlo y mantenerlo.